95%
比全量微调所需参数更少
LoRA 通过轻量级适配层进行增量学习,而不是重写整个模型。
LoRA 训练工具
把少量参考图训练成可复用的角色 LoRA。生成无限变化——新姿势、新服装、新场景——同时保持同一张脸和人物气质。
10–30 张图片 → 15–30 分钟 → 可用于生产的一致性。
Paste your story, then choose the page count and layout.
Training plan
95%
LoRA 通过轻量级适配层进行增量学习,而不是重写整个模型。
1-10min
足够快,适合反复迭代;也足够稳定,适合生产流程。
1-10MB
体积小、易携带,可复用,也可叠加使用。
10-30
精心筛选的数据集,胜过一个杂乱的大文件夹。
Built for the work
LoRA 训练:为一致性而生的自定义角色模型,真正能用于生产。
几分钟就能训练,不用等几天。像创作者一样迭代,而不是像实验室一样慢慢调。
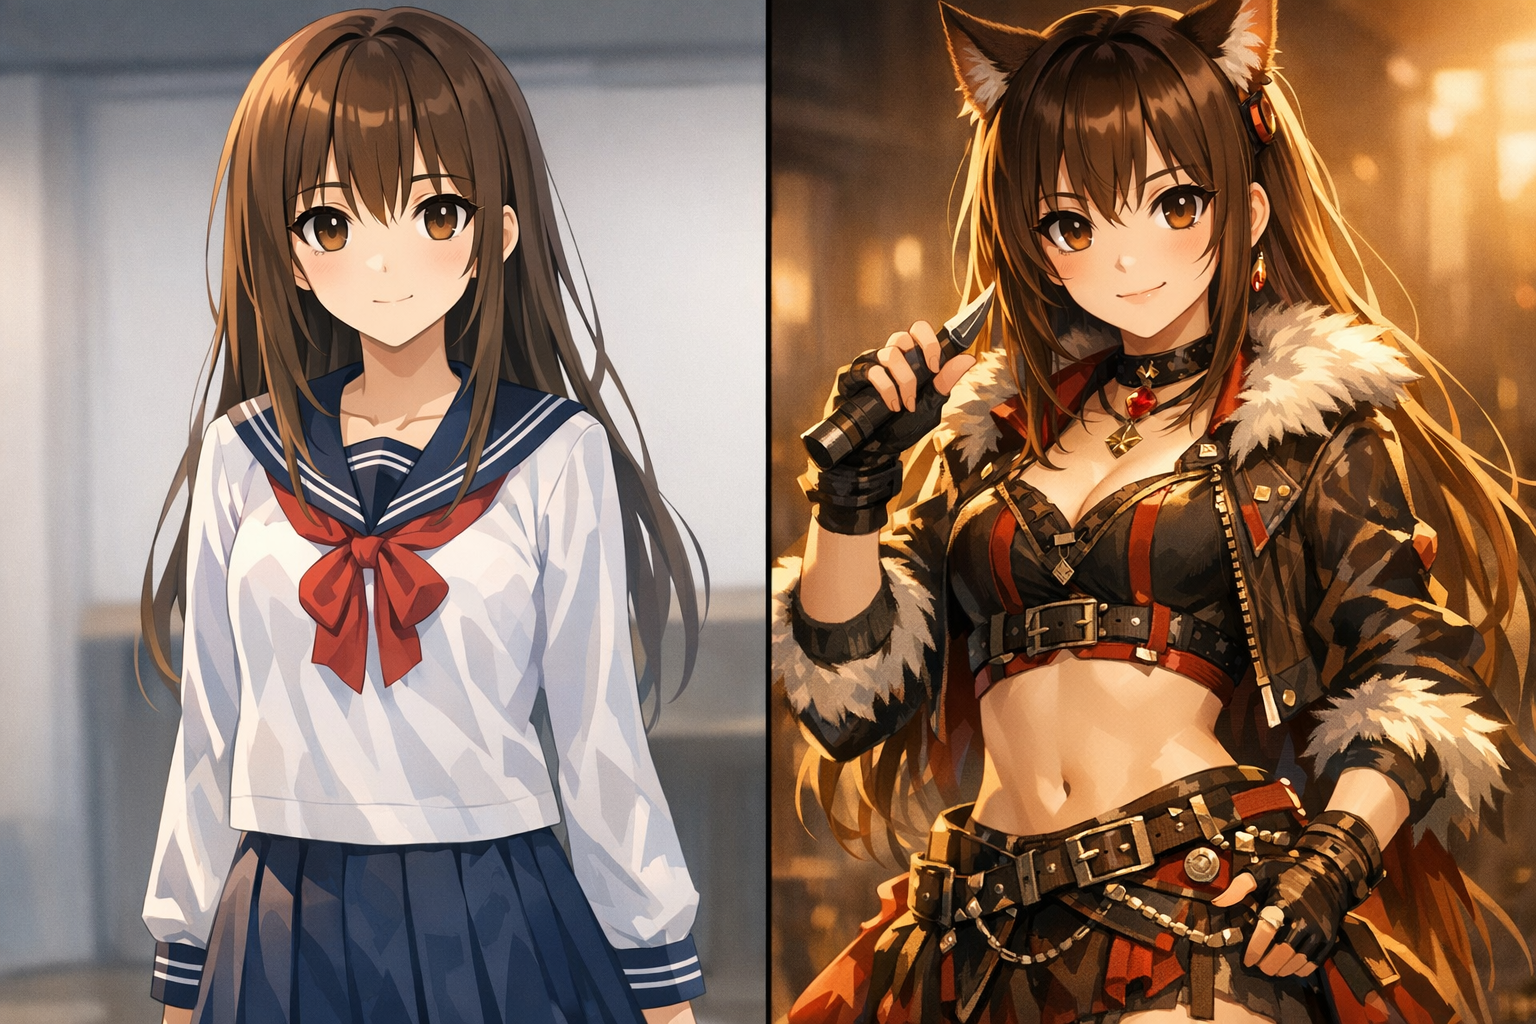
每次生成都能保持相同的眼睛、鼻子、嘴巴和比例,不会出现身份漂移。
只需 10–30 张精心挑选的参考图,就能获得不错的效果。
2–10MB 的适配器易于存储、分享,并可在不同项目中复用。
在切换场景的同时,保留你的艺术特色——线条、配色、构图都不丢。
从严格锁定身份到更柔和的风格引导,都能按需调节。
将角色 LoRA 与风格 LoRA 组合使用,获得更深层的控制。
可生成日漫、游戏、故事板、营销素材和系列化内容所需的资产。
Foundation
LoRA(Low-Rank Adaptation,低秩适配)是一种参数高效的微调技术,它能在不修改模型数百万核心权重的前提下,让现有模型学习新的特定知识。它通过添加小型适配层实现,所需算力大幅降低,同时还能保持很高的还原度。你可以把它理解为训练一个 AI 绘师,让它识别并稳定复现你角色的“DNA”:脸部比例、表情、配饰和风格特征。只需 10–30 张精心整理的图片,就能解锁可无限复用的一致性生成,适用于日漫分镜、游戏资产、故事板和品牌角色。
Continuity
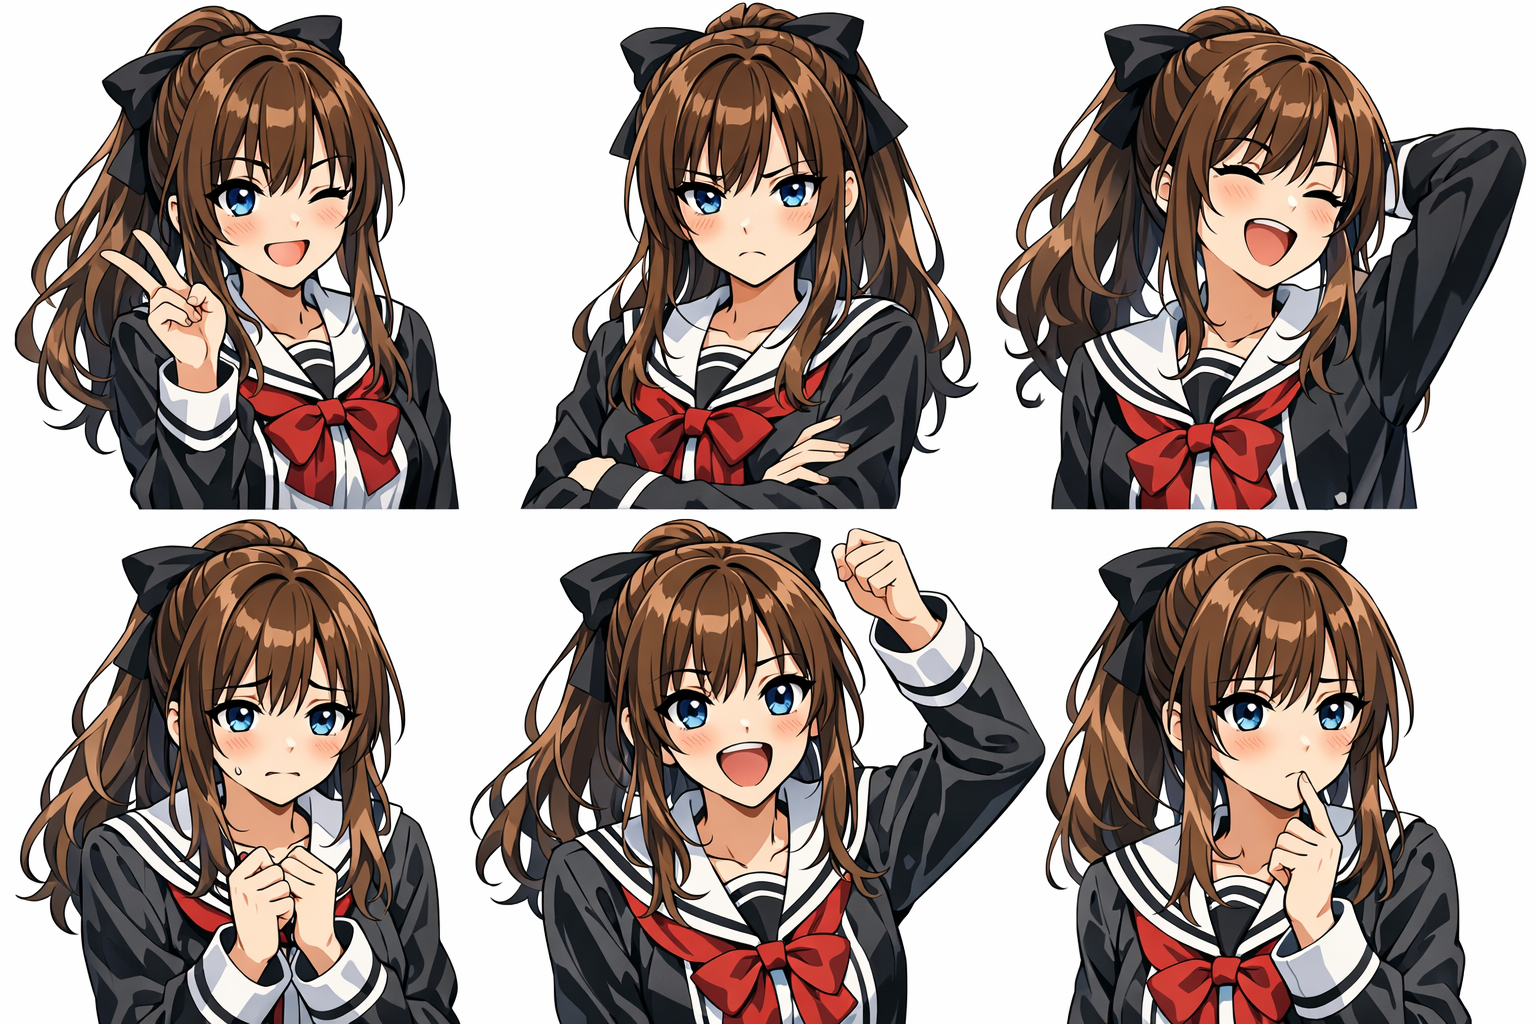
在视觉叙事中,一致性是信任的基础。若角色在不同场景里脸型、发长、眼型或比例不断变化,观众就会产生割裂感。标准文生图是非确定性的:同一句提示词每次生成出来的身份都可能不同。LoRA 训练会把身份编码进可复用模型中,让角色在各种变化下依然可被识别。
每次生成都保持相同的眼睛、鼻子、嘴巴和比例。
在不同场景和构图中延续你的艺术方向。
呈现新的情绪,同时不丢失身份。
保留同一角色的同时,获得无限角度和取景方式。
更换服装、道具和细节,不会造成脸部漂移。
在不同光线、背景和氛围下依然保持可识别。
How the method works
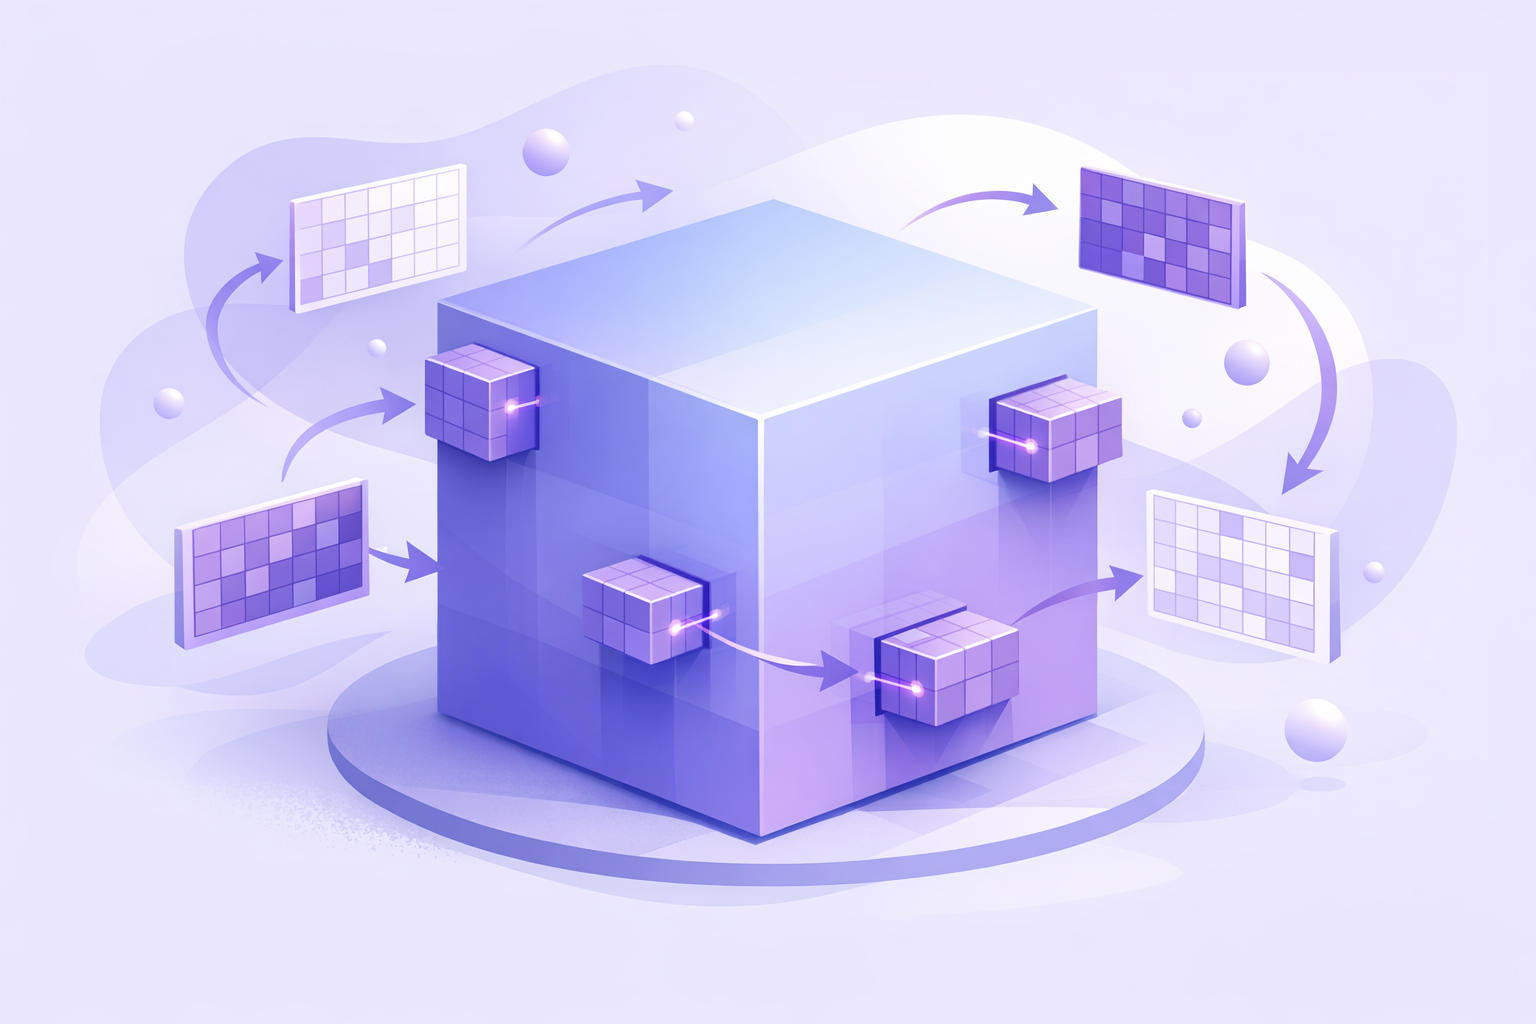
全量微调会重写模型的核心权重——成本高、脆弱,也更容易过拟合。LoRA 则保留基础模型不变,通过轻量级适配器学习低秩更新。你可以获得有针对性的学习效果(身份、风格、概念),同时参数更少、文件更小、训练更快——非常适合创作者反复迭代。
01 / Proof in the output
让模型学会“这是谁”。经过筛选的参考集可以锁定脸部和关键设计特征,让每次新生成都还是同一个角色。
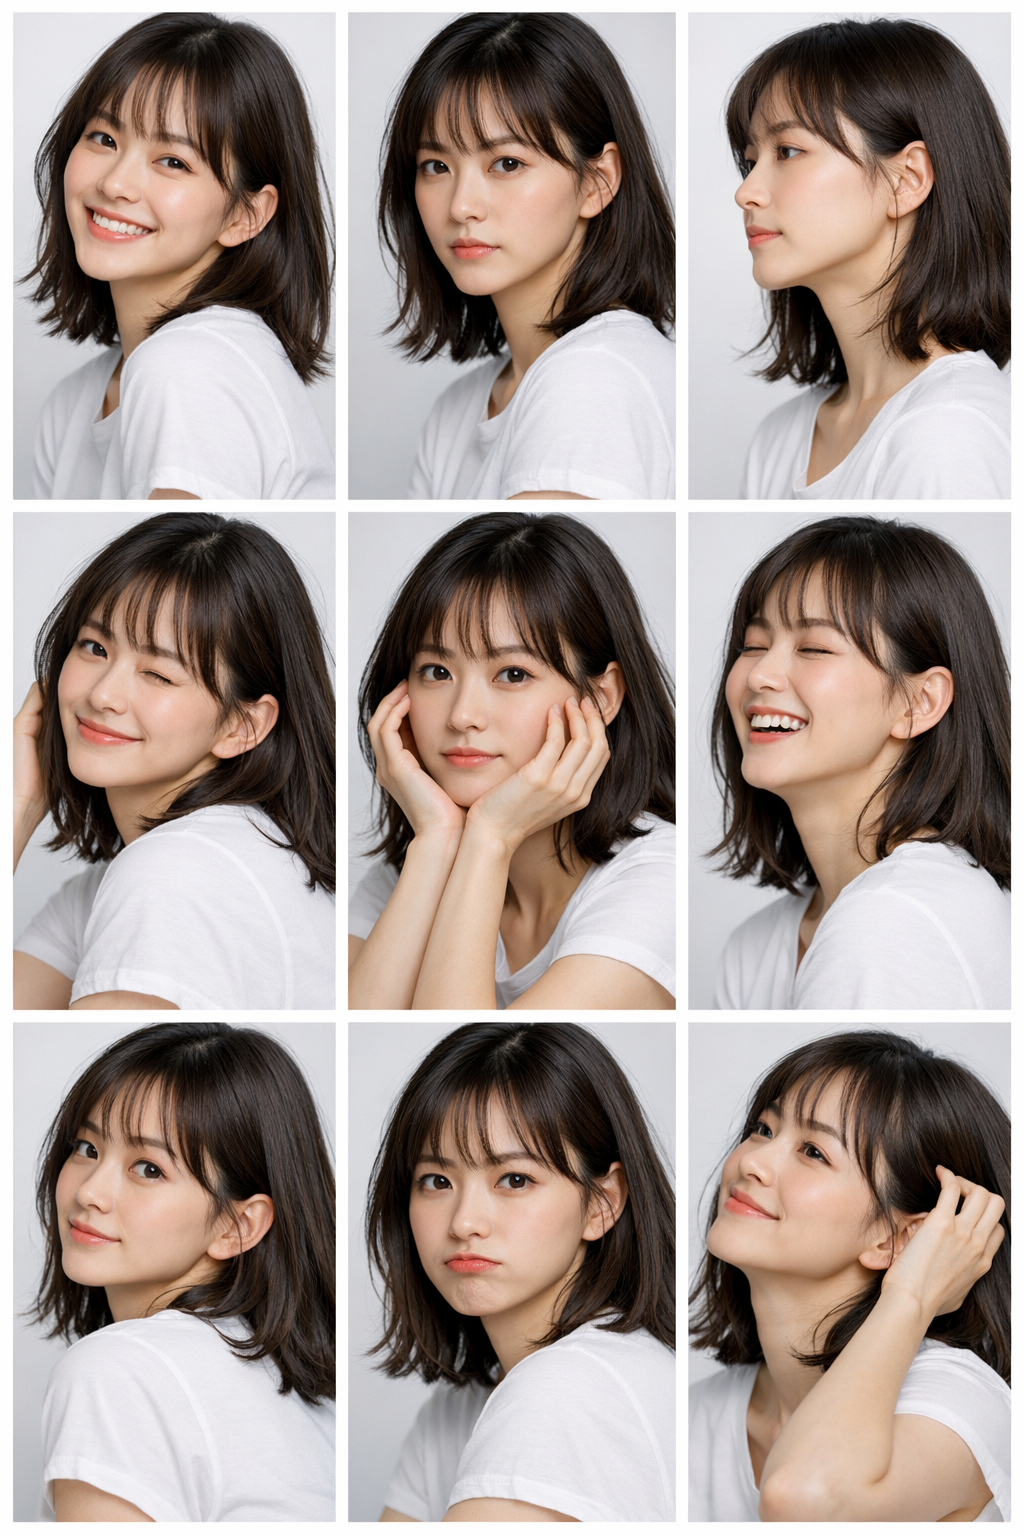
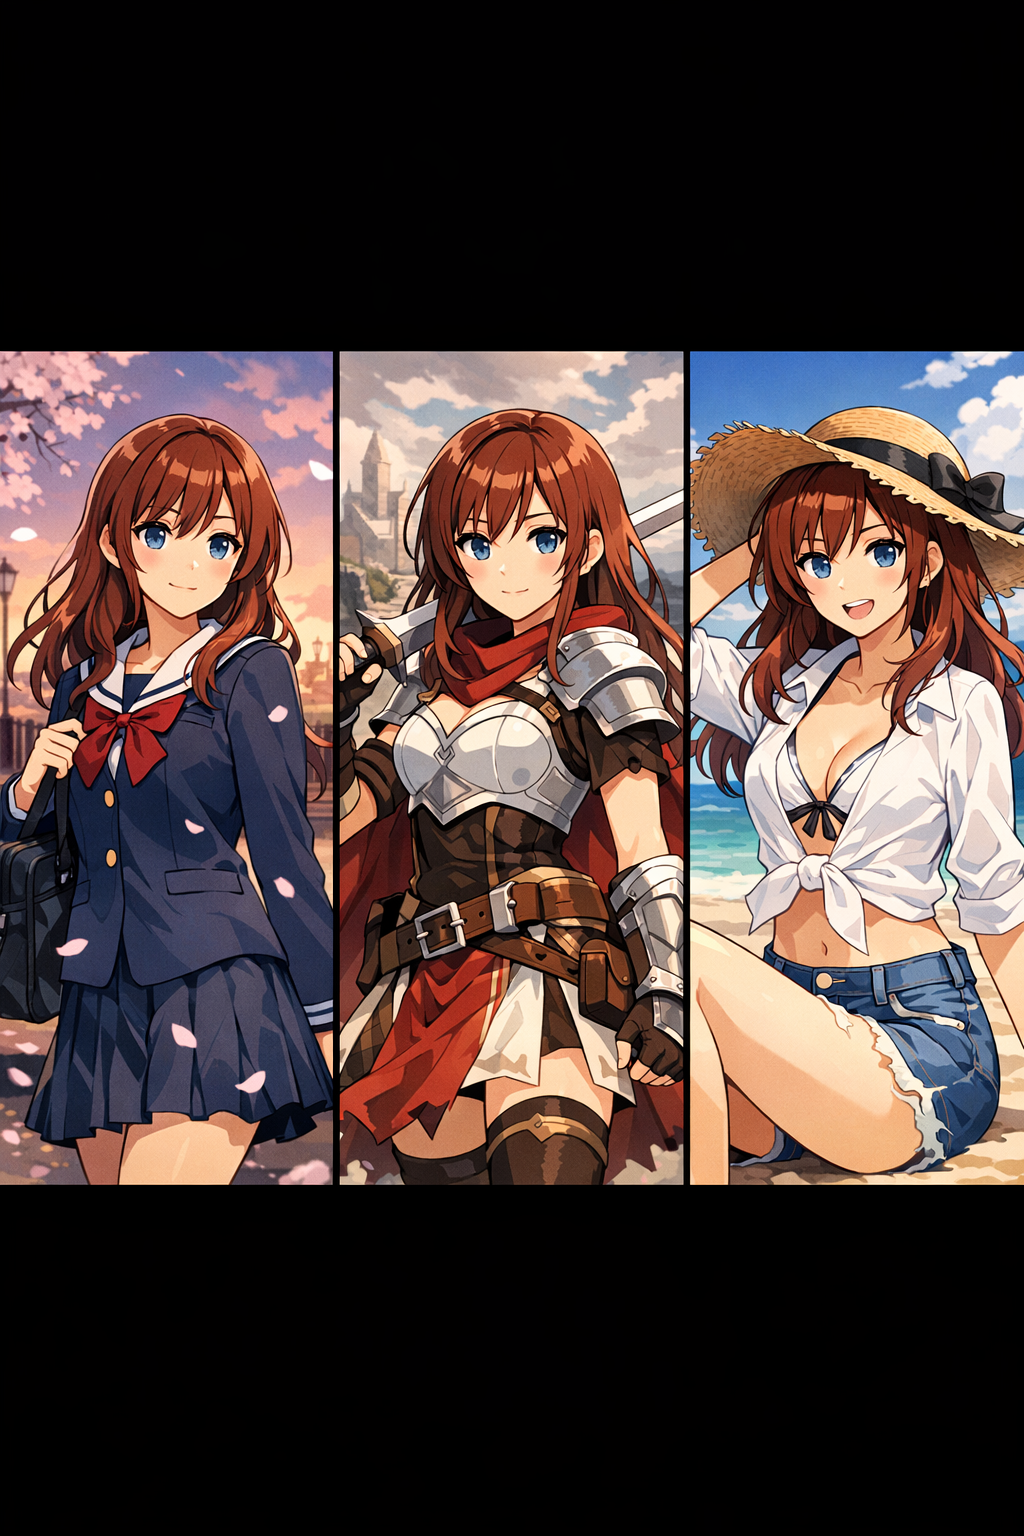
02 / Proof in the output
训练、测试、调整、再重复。逐步调节身份强度、风格贴合度和灵活性,让结果匹配你的生产需求——无论是日漫页面、游戏、营销还是系列内容。
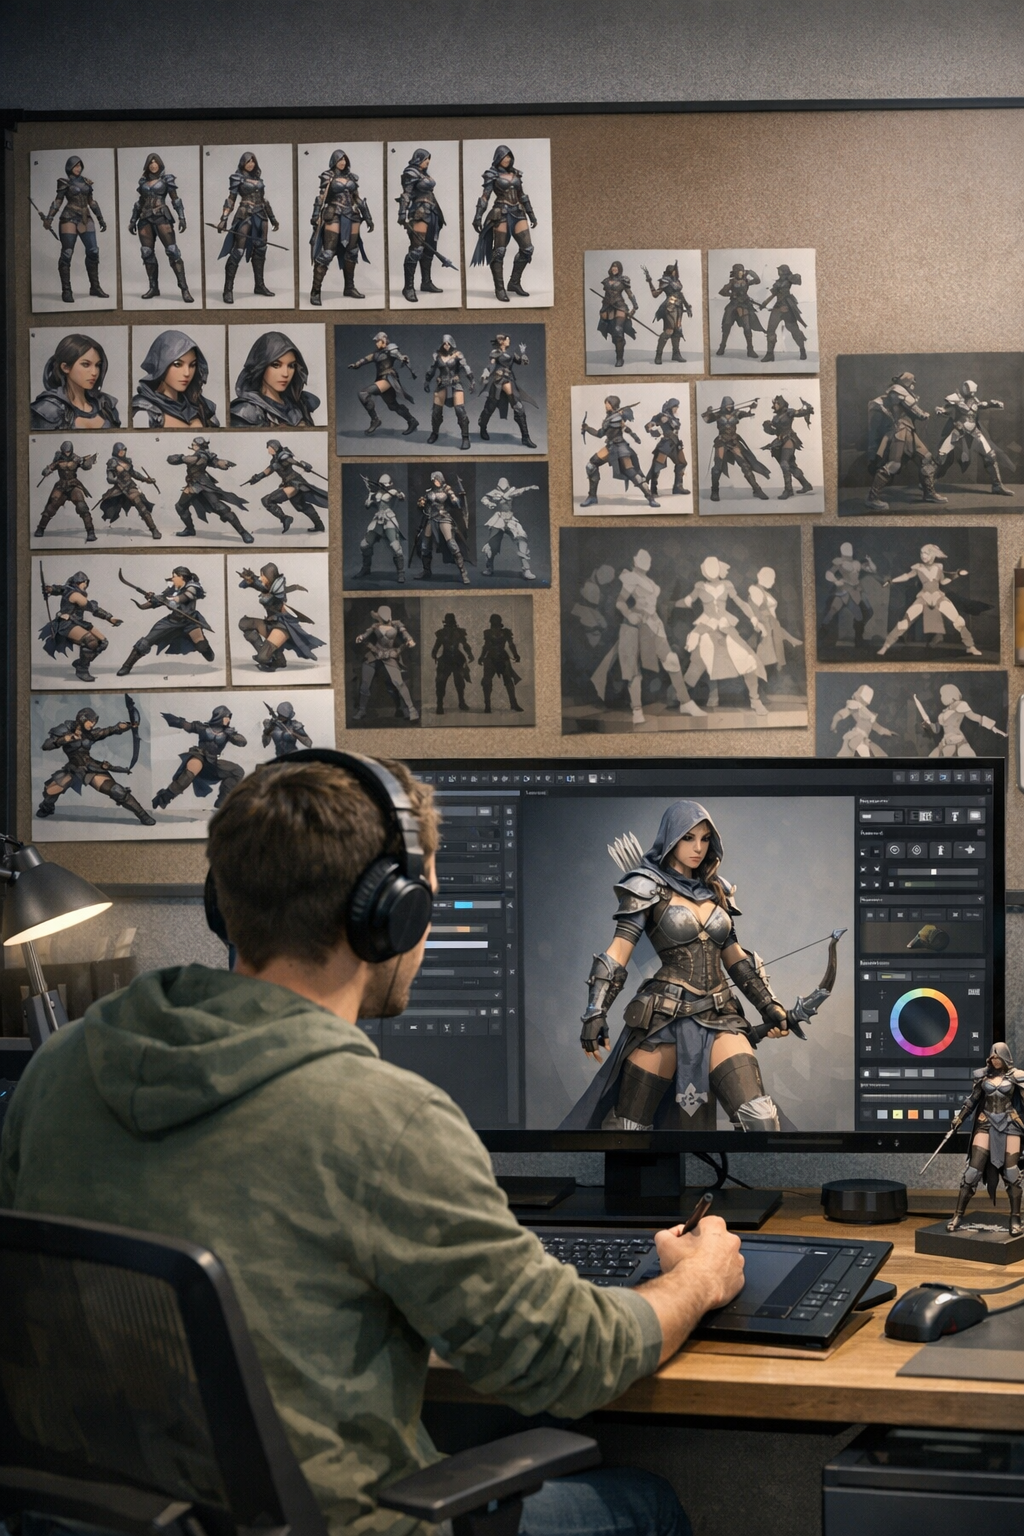
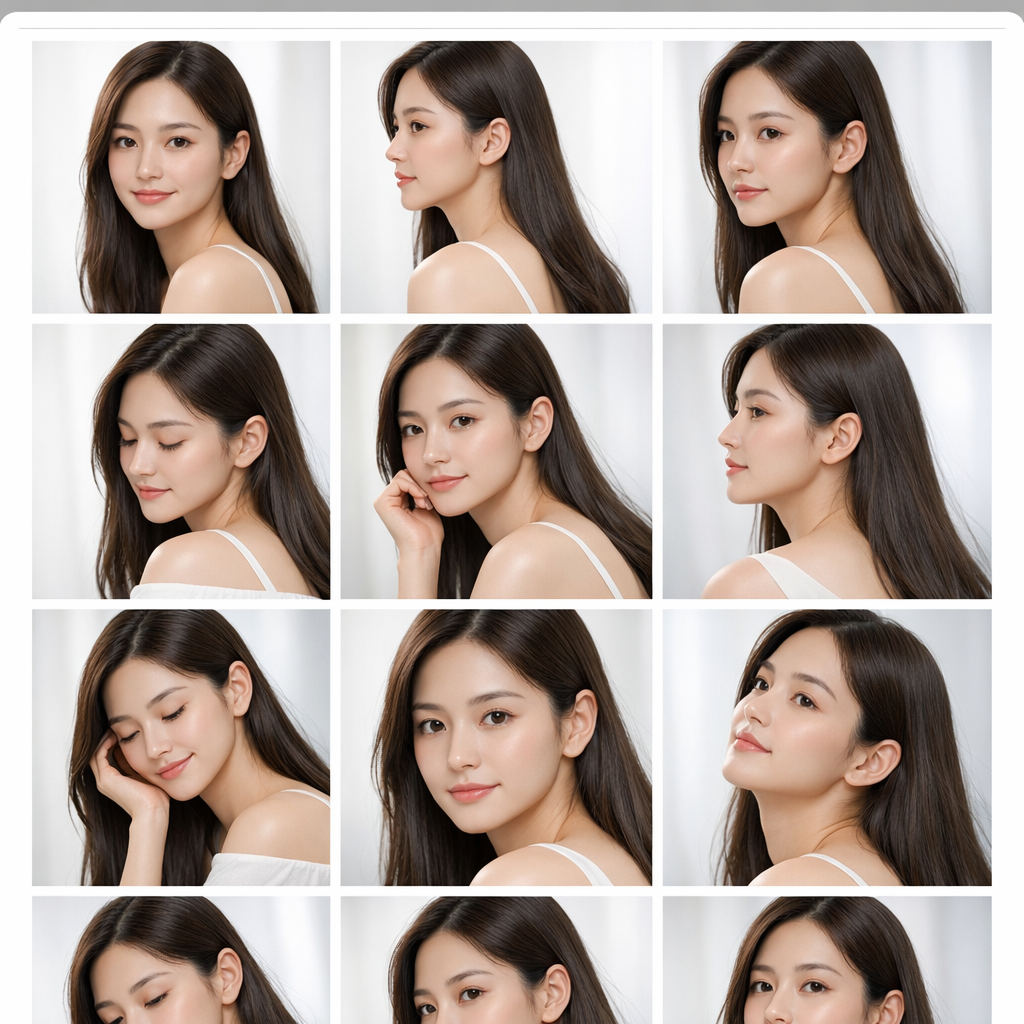
Detailed process
几分钟即可开始,无需机器学习背景。
Step 01
收集 10–30 张高质量图片。姿势、角度和表情可以有变化,但身份要保持一致。尽量裁切清晰,避免重滤镜和混杂主体。
Step 02
选择基础模型(动漫/写实/艺术风格),然后设置训练轮次和学习率。我们的默认参数适用于大多数场景;如需更高精度,也可以使用高级控制项。
Step 03
开始训练并监控进度。大多数任务会在 15–30 分钟内完成,具体取决于数据集和复杂度。
Step 04
使用训练好的 LoRA 生成一致的变化:服装、姿势、场景、光线和表情都可以变,但身份不会漂移。
Where it fits
创作者如何借助 LoRA 训练提升产能,同时不牺牲角色一致性。
为日漫系列、网络漫画和图像小说的数百个分镜生成一致角色——从第一章到最终章都保持统一。
为主角、NPC 和皮肤创建立绘、头像、关键视觉稿和情绪状态变化。
打造完整的表情和服装套组,同时保持整个故事前后一致。
为动画和游戏团队生成包含角度、表情和服装包的设计稿。
通过一致的吉祥物模型,在营销、社媒、周边和广告中保持品牌统一性。
在正式制作前,先完成故事板、概念场景和角色研究。
通过生成一致的角色内容和活动素材,提升受众识别度。
为收藏品和产品线创建可直接印刷的角色图,且保持统一呈现。
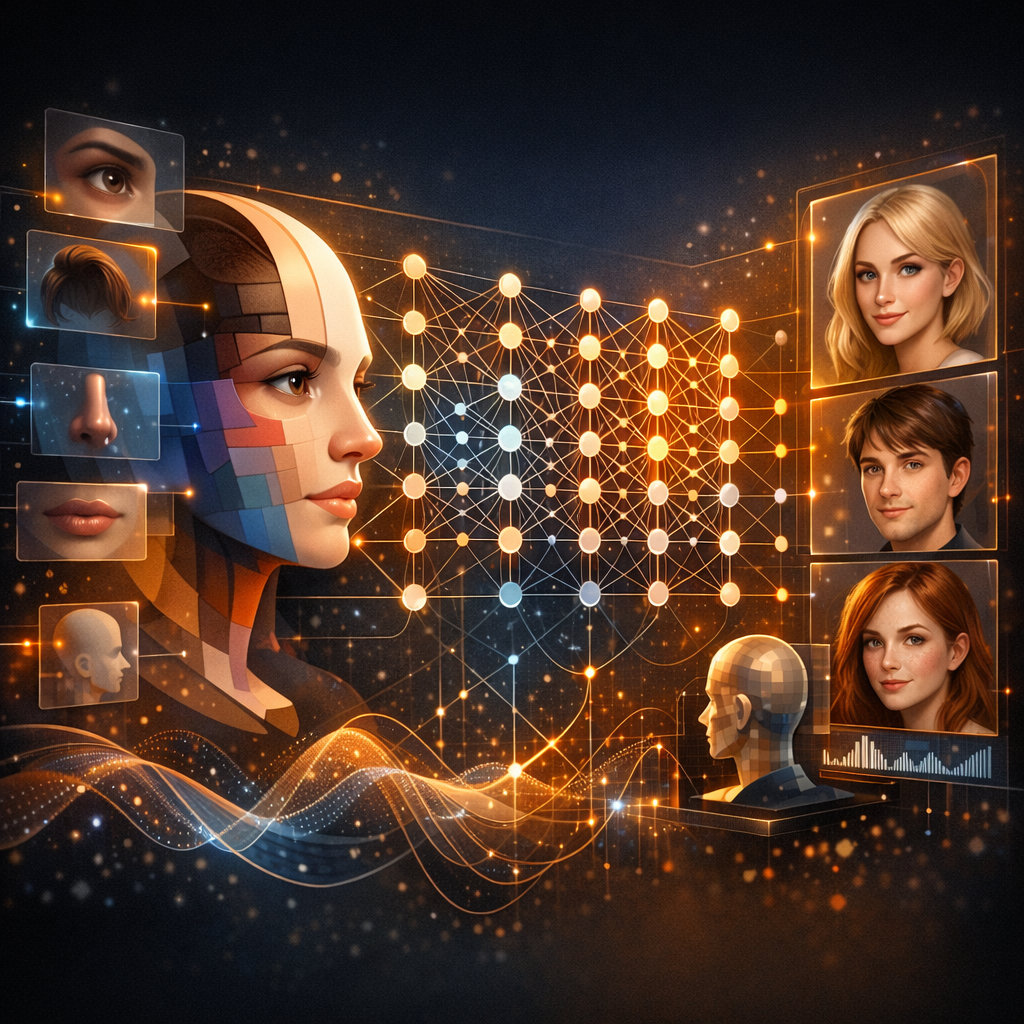
Output gallery
LoRA 训练 + Character Studio 可实现的效果示例。
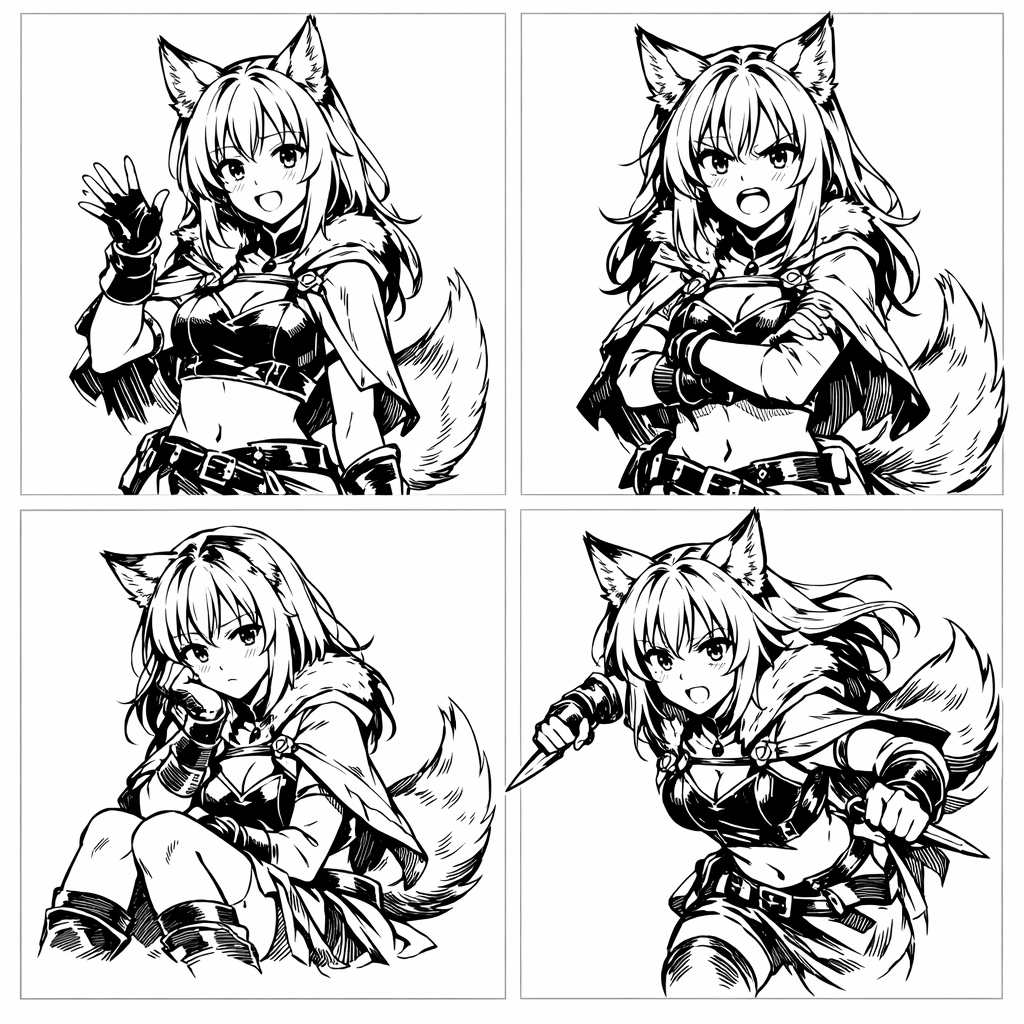
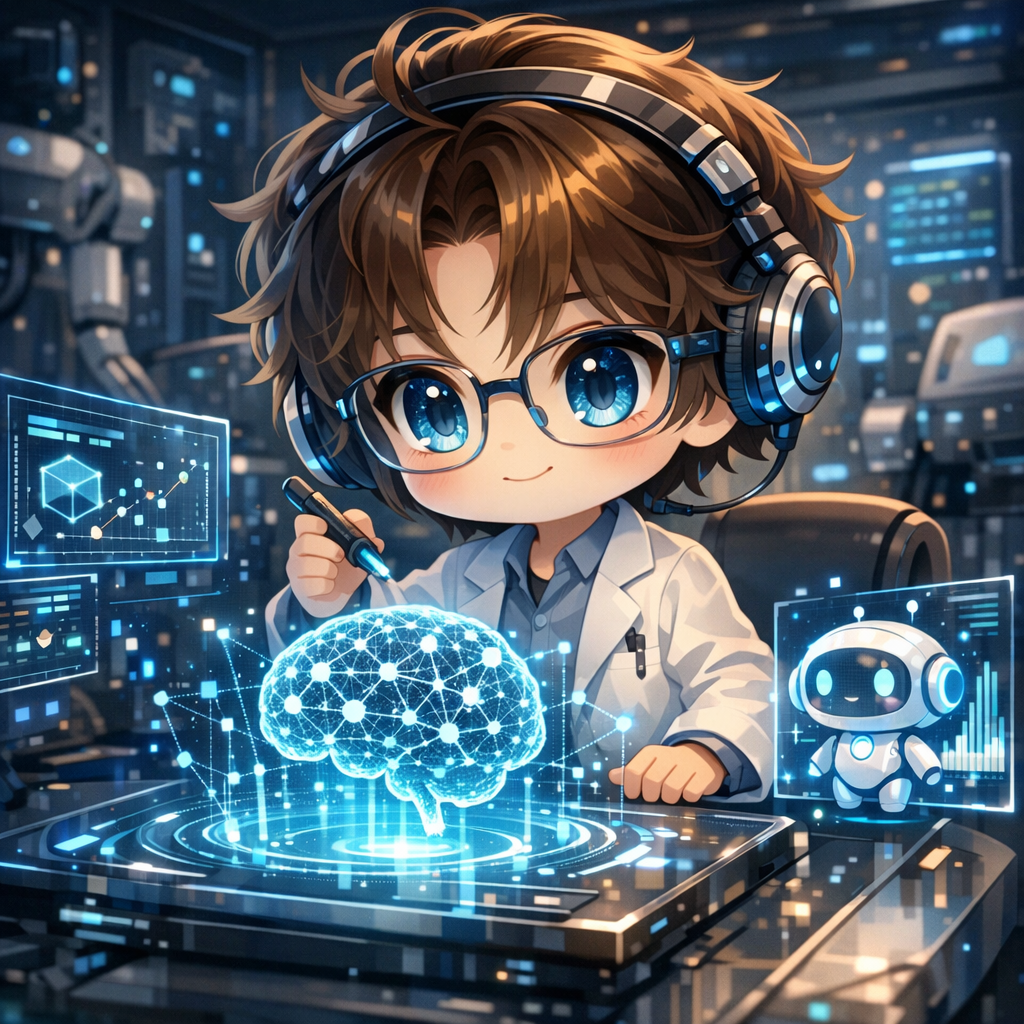
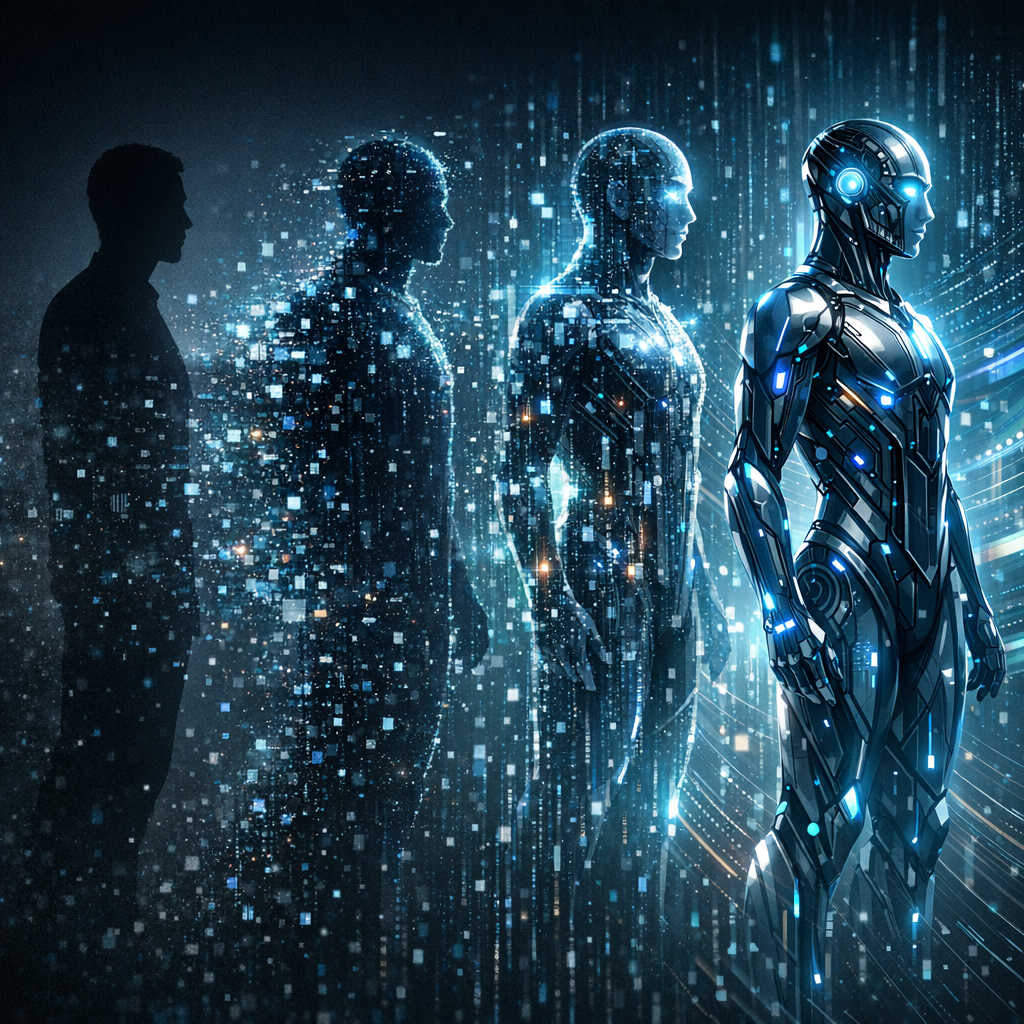
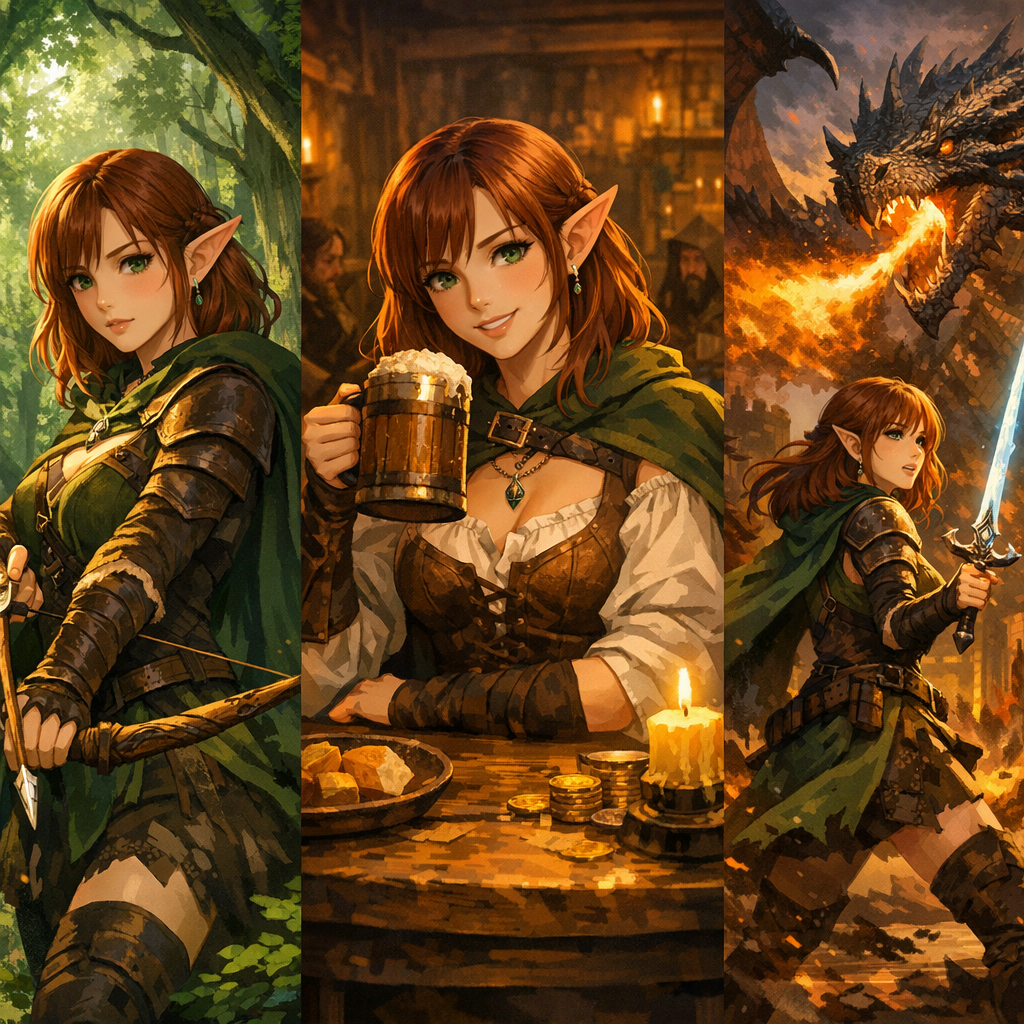
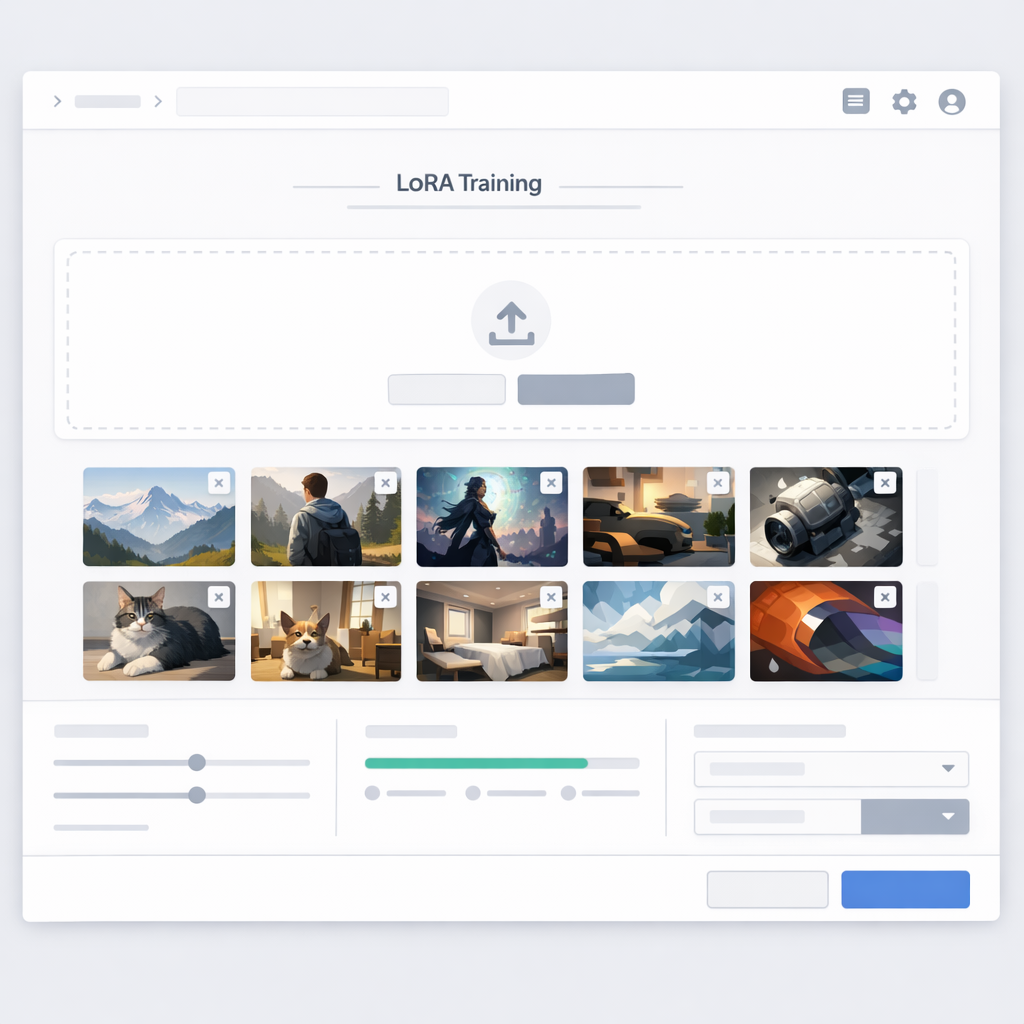
Workflow
面向一致角色生成的实用工作流。
收集能代表同一身份的图片,涵盖不同角度、表情和光线。输入越干净,一致性越好。
运行一个轻量级训练任务,学习身份/风格信号,同时避免过拟合。
在 Character Studio 中使用训练好的 LoRA 生成新场景、服装和姿势,同时保持脸部稳定。
Where it earns its place
只有一致性,才能把好看的图片变成可用的故事生产线。
在更换背景、镜头角度或服装时,依然保持同一个角色脸部。
一旦身份被锁定,就不必为了对上角色而反复重抽生成结果。
适用于漫画、日漫、网络漫画、缩略图以及任何多图叙事工作流。
训练、测试、调整——目标是可重复的生产输出,而不是一次性演示。
把训练好的 LoRA 当作可复用的角色资产,直接带入新项目。
直接进入 /new/characters 进行生成、优化,并持续扩充你的角色阵容。
FAQ
通常 10–30 张经过筛选的图片就够了。图片要有一定变化(角度、表情、光线),但身份必须一致。干净的数据比更多的数据更重要。
主体清晰、身份一致、视角多样、光线良好,并且裁切紧凑。避免混杂主体、极端滤镜、严重遮挡,或同一组里风格差异过大。
可以——训练得当时,LoRA 能在你更换提示词、服装、环境和光线时,依然保留面部身份。
大多数任务会在 15–30 分钟内完成,具体取决于数据集大小和复杂度。
全量微调会更新模型的大部分权重(算力更高,也更容易过拟合)。LoRA 则学习轻量级适配层(更快、更小、也更容易复用)。
通常可以。将角色 LoRA 与风格 LoRA 叠加,往往能获得更深层的控制——既保持身份稳定,又能切换艺术方向。
你拥有在 LlamaGen 中创作的内容。请确保你的数据集和提示词遵守第三方权利和知识产权要求。
打开 /new/characters 的 Character Studio,使用训练好的角色身份生成新图片。
训练一次,就能一直生成——每个场景都保持一致的脸。