理解场景的镜头拆解
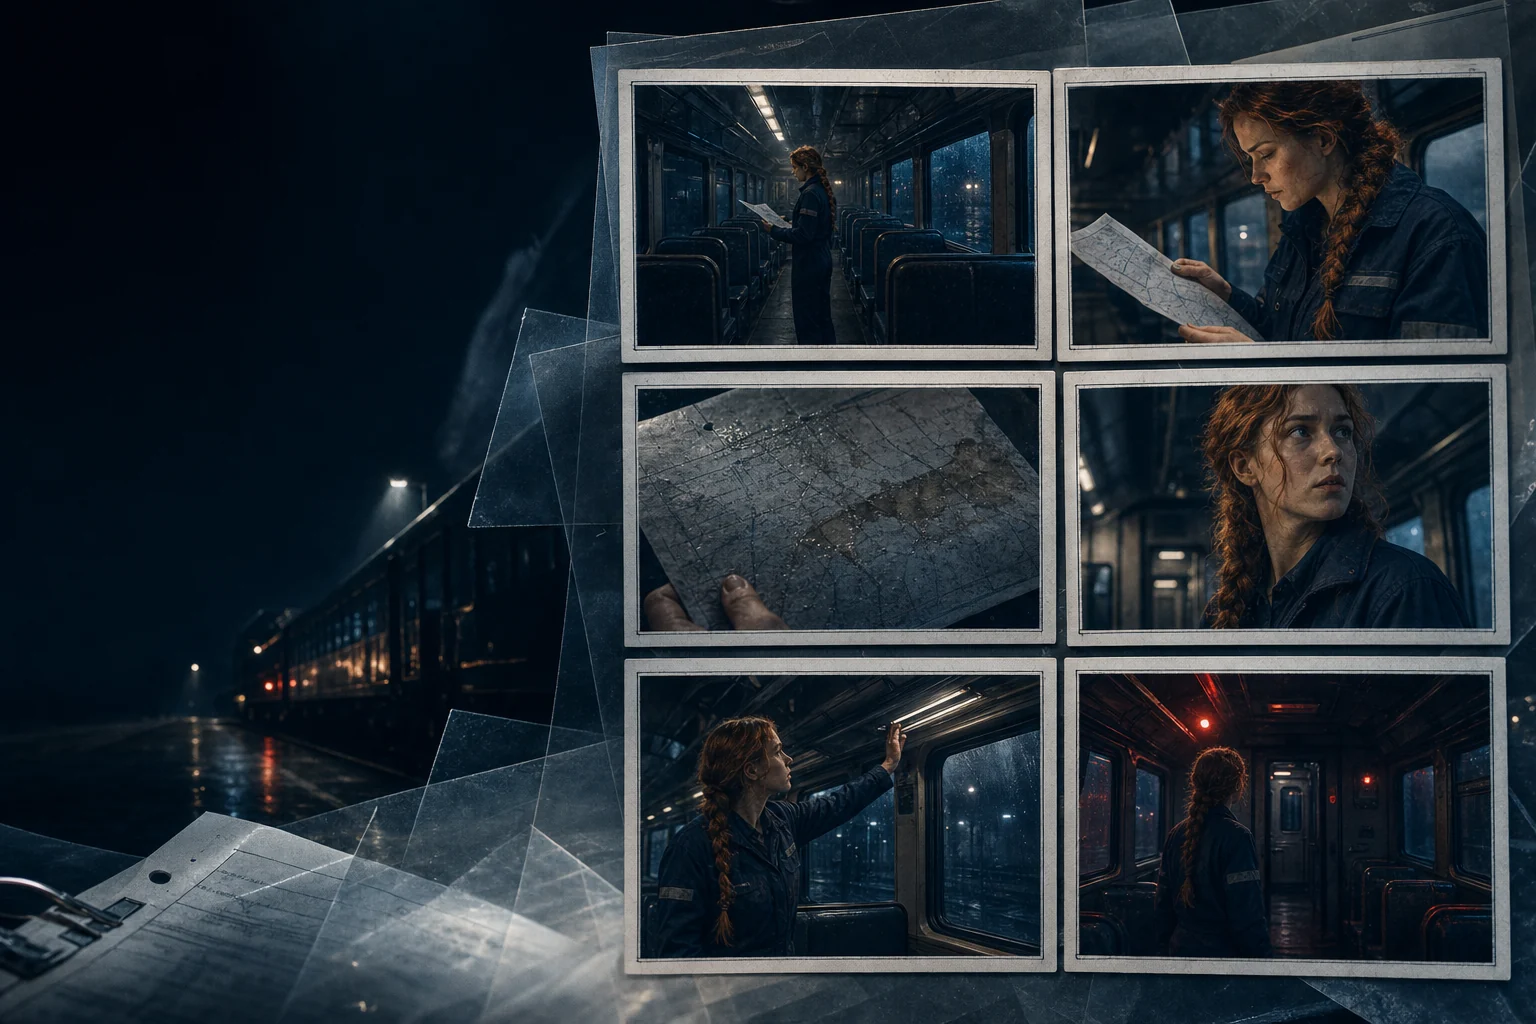
把动作和对白转化为开场镜头、覆盖镜头、插入镜头、反应镜头和转场,并明确每个镜头的叙事目的。
不只是图片集合
优秀的分镜会保留动作、视线、画面方向、表演和视觉连续性。LlamaGen 将图像生成与那些让一个段落更容易理解的关键决策连接起来。
把动作和对白转化为开场镜头、覆盖镜头、插入镜头、反应镜头和转场,并明确每个镜头的叙事目的。
说明景别、角度、运动、构图、镜头感和表演重点,而不是把每个选择都交给运气。
复用角色、地点、道具和之前的画面,让镜头变化时整个段落仍然连贯。

示例 · 可被指导的 AI
模型可以提供视觉选项,但创作者仍然决定走位、重点、节奏,以及观众应该感受到什么。最好的提示词,就是一份简洁的导演简报。
工作流程
先从意义出发,再到覆盖镜头;只有场景有了视觉计划,才开始生成。
先明确谁想要什么、哪里会发生变化,以及观众最先需要看到什么信息。
为段落中的每个镜头选择构图、角度、主体、动作和连续性说明。
对比不同视觉方向,保留最强参考,并在清晰度或连续性出问题时迭代。
常见问题
可以,但最强的工作流是按场景逐个处理。先审阅戏剧节拍和镜头顺序,再生成大批量画面。
应包含主体、动作、情绪、地点、时间、景别、机位角度、构图、光线、风格,以及必须与相邻画面匹配的连续性细节。
使用稳定的角色参考,重复一组简短身份锚点,把永久特征和场景专属服装区分开,并在工作时对照相邻画面。