最适合动漫视频的 AI 生成器取决于你的起始素材。已批准的角色图、一组漫画分镜,以及实拍素材,各自都需要不同的工作流程。在比较模型名称之前,先比较你手头的输入素材和你需要的结果。
对于一个反复出现的角色来说,一个强有力的开场帧只是开始。面部、服装、道具和绘画风格都需要在角色运动时保持可用。一个完成的序列还需要兼容的转场、节奏和声音。
本指南围绕以图像为主导的工作流,对 LlamaGen.AI、Vidu、Kling 和 Runway 进行比较,并将 DomoAI 作为视频重绘工具单独考虑。如果你已经有漫画素材,请打开 LlamaGen.AI Comic to Video 来评估分镜转动态的工作流。
证据与披露 — 2026 年 11 月 5 日: 本文由 LlamaGen.AI 发布。工具描述基于下方链接的官方资料。我们还审查了两个现有且归属明确的动漫展示片段的文件和抽样帧,这些片段在其生成清单中被记录为 Vertex AI Veo 3.1 Quality 输出。这些片段是通过营销工作流制作的,而不是针对当前产品工作室的受控对比。我们没有在全部五项服务中运行相同提示词、测量生成成本,或判定质量优胜者。本文包含可播放示例,方便你自行检查完整运动表现。
先选择输入路径
| 你拥有的素材 | 值得研究的路径 | 测试必须确认的内容 |
|---|---|---|
| 一段书面场景 | 文本转视频 | 场景和角色设计是否符合你的需求说明 |
| 一张已批准的动漫静帧 | 图片转视频 | 运动是否保留了可见设计 |
| 角色与场景参考图 | 参考图驱动视频 | 每张参考图是否都发挥了预期作用 |
| 完成的漫画分镜 | 分镜转视频工作流 | 序列、构图和剧情节奏是否依然清晰 |
| 现有动态视频素材 | 视频转视频 | 风格重绘是否保留了表演和节奏 |
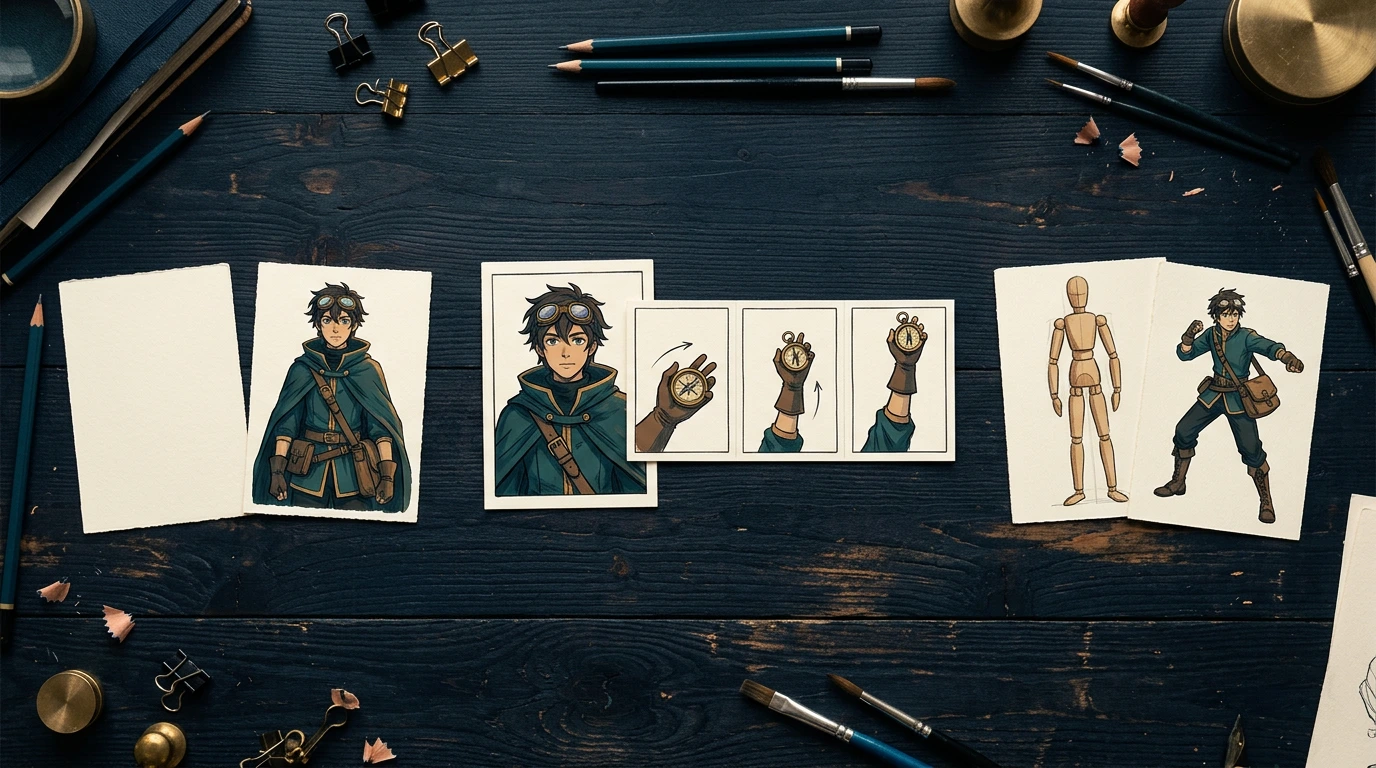
教学示意图:静态图像动画化与对现有动态进行风格重绘是两种不同任务。这些卡片并不是经过测量的工具输出结果。
在第一次测试中,选择一个小动作:转头、抬手举起道具,或走几步。复杂的打斗场景会引入太多故障点,难以及时诊断。
按工作流比较工具
以下是基于公开能力文档整理的编辑部候选推荐。它们并不对动漫质量、生成速度或价格做量化排名。
| 工具 | 值得研究它的一个理由 | 这里使用的证据 | 仍需测试的内容 |
|---|---|---|---|
| LlamaGen.AI | 将连续漫画素材延展为动态内容 | 公开工作流页面;两个现有的脚本生成展示片段 | 当前工作室控制项、实际成本,以及重复角色序列 |
| Vidu | 图片和参考图驱动视频 | 当前 Q4 产品说明 | 你的角色、所选模式、设置和显示的任务价格 |
| Kling | 运动控制与参考图驱动创作 | 官方 4.0 和图片转视频指南 | 账户中实际可用的控制项,以及你具体镜头的结果 |
| Runway | 在更广泛视频工作区中的图片驱动生成 | 官方 Gen-4.5 创建与提示指南 | 你的关键帧、编辑内容和可接受输出成本 |
| DomoAI | 对已有运动的视频素材进行风格重绘 | 官方 Video to Video 文档 | 你的表演、细节和音频在重绘后是否得以保留 |
LlamaGen.AI:适合将漫画资产延展为动态内容
LlamaGen.AI 最适合用于将脚本转为可复用漫画分镜和适合动画制作的故事资产的工作流。它的 Comic to Video 页面 指向 Animation Studio,并将任务定义为围绕已准备好的漫画素材和序列规划展开。
这使它在工作从分镜而非空白视频提示词开始时,成为一个实用选择。请将分镜顺序、角色参考和动作说明放在一起。承诺具体模型、配乐或导出方式之前,请先检查当前工作室的可用选项。
本文后面的两个示例展示的是现有动漫动态资产。它们记录的模型来源仅属于这些文件本身。这并不能证明当前工作室使用相同提供商,也不能证明每个分镜序列都能保持角色一致性。
Vidu:适合探索图片和参考图驱动视频
Vidu 当前的 Q4 页面 描述了单图动画和参考图转视频工作流。当你想测试角色、场景和风格参考图如何引导一个镜头时,它值得研究。
参考图转视频和图片转视频是不同模式。请比较你实际打算使用的模式,并记录哪张图片定义角色、哪张定义场景。额外的参考图容量本身并不能证明更好的身份一致性保留。
我们在这里没有运行 Vidu 的生成测试。请在实时应用中查看可用控制项和任务成本。较旧的 Q3 API 价格不应被视为 Q4 应用生成的价格。
Kling:适合控制明确的主体与动作
Kling 的官方图片转视频指南强调对主体及其动作进行描述。其较新的 Kling 4.0 指南 发布于 2026 年 11 月 4 日,描述了更广泛的参考图驱动工作流,并指出实际可用性取决于产品界面。
这使 Kling 值得用于测试定义明确的镜头。先从一个动作和一条镜头指令开始,然后检查完整结果。参考图功能是需要测试的控制项,而不是脸部、手部和服装一定保持不变的证明。
我们在这里没有测试 Kling 4.0。在没有确认所选版本和模式之前,不要把旧模型的限制或价格带入当前对比中。
Runway:适合图片驱动生成并继续进行视频制作
Runway 的 Gen-4.5 指南记录了文本转视频和图片转视频的创建方式。当前指南列出了 2–10 秒时长、720p 输出,以及每生成 1 秒需 12 credits,并要求 Standard 或更高等级。
当一个镜头会继续进入更广泛的生成与编辑工作流时,它是一个候选方案。其提示词指南建议使用清晰的动作描述和正向措辞。例如,直接描述固定机位,而不是依赖一长串被禁止的运动描述。
这些都是文档中记录的条件,而不是账户实测结果。我们没有测量 Runway 的动漫还原度、排队时间或可用输出率。
DomoAI:用于重绘动态视频素材的独立路径
DomoAI 的 Video to Video 文档描述了如何将包括动漫在内的风格应用到上传视频。这使它在已有动作、任务只是改变外观时,值得评估。
源素材中的表演本身提供了节奏,而静态图像动画工作流则必须自行创造这些节奏。如果不说明这种差异就把两者直接比较,会让重绘工具在动作时序上获得不公平优势。
请使用同一份原始视频素材进行单独的重绘测试。检查面部、手部、服装边缘和音频。关于保留动作或音频的文档说明,并不能证明你的输出会完美保留。我们在这里没有进行 DomoAI 测试。
两个真实动漫片段:文件与帧展示了什么
我们将两个保留的宣传文件与其现有提示词和源图像进行了核对。每个文件都包含 8 秒的 1080 × 1920 H.264 视频,帧率为 24 fps:共 192 个视频帧,外加一条立体声 AAC 音频流。音频流的存在并不能证明配乐质量或同步性;我们没有对音频进行评分。
保留的清单并不能证明原始生成日期、总尝试次数、等待时间或最终成本。媒体 URL 中带日期的文件夹并不能证明生成发生的时间。
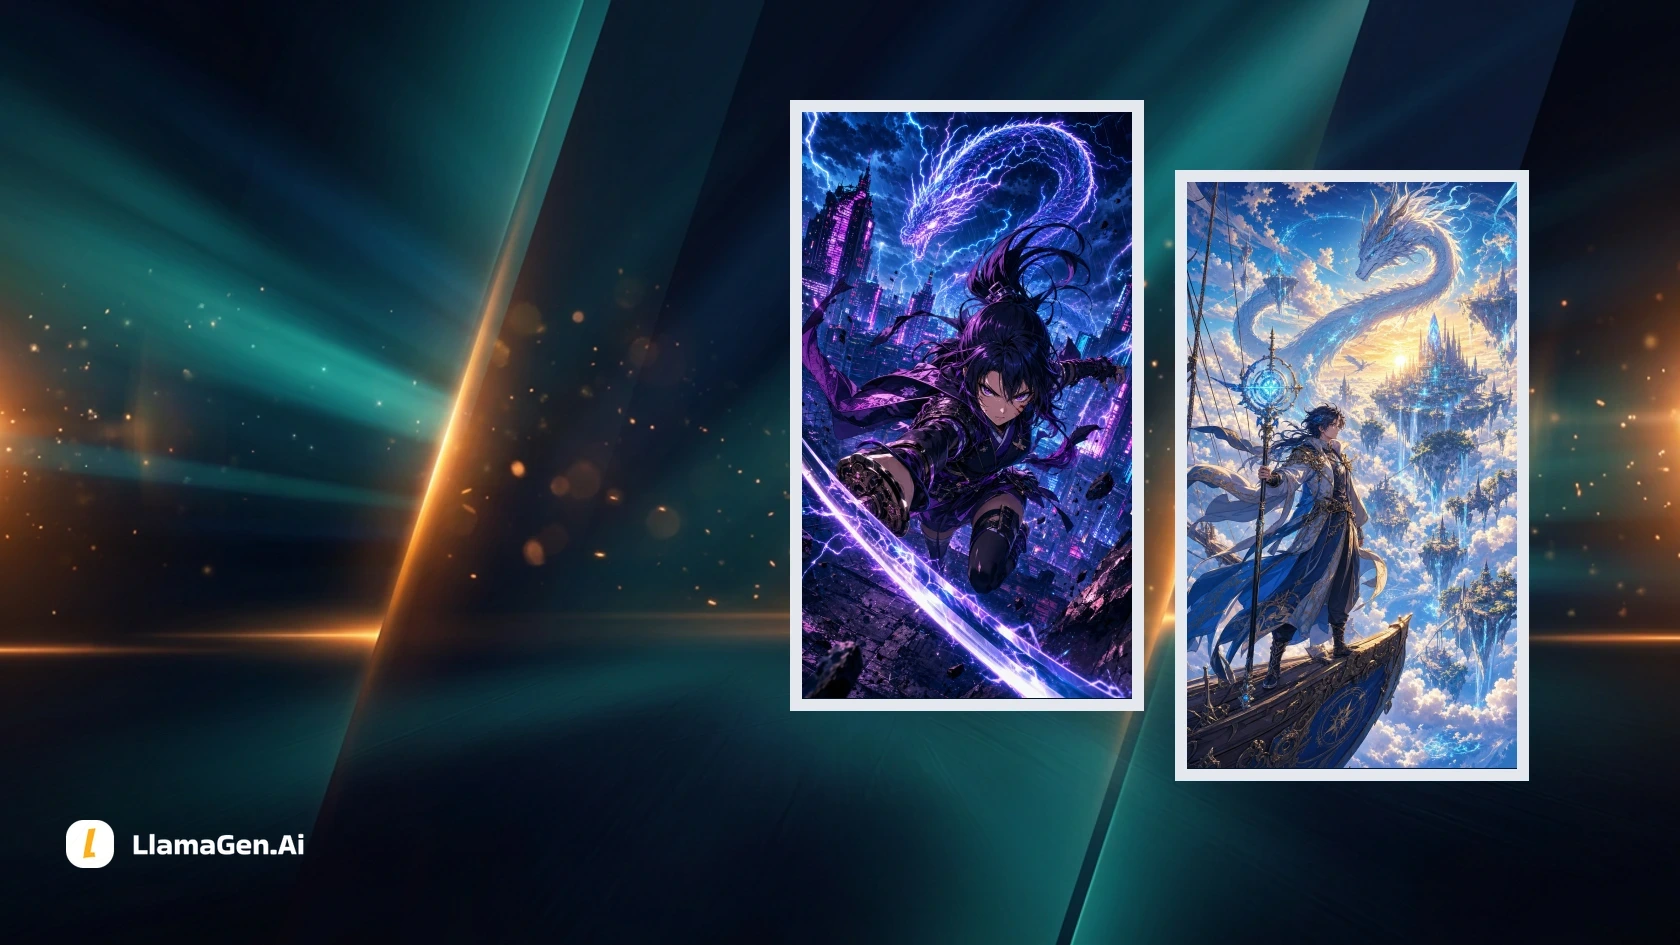
动作示例:闪光可能会遮挡你需要判断的细节
记录模型:Vertex AI Veo 3.1 Quality。这是一个现有的脚本生成展示片段,不是新的受控工作室测试。
原始提示词要求根据提供的插图制作一个竖屏动漫预告片,包括镜头推进、一次挥剑、电能效果、短暂的冲击闪光,以及一个锐利的结尾定格。
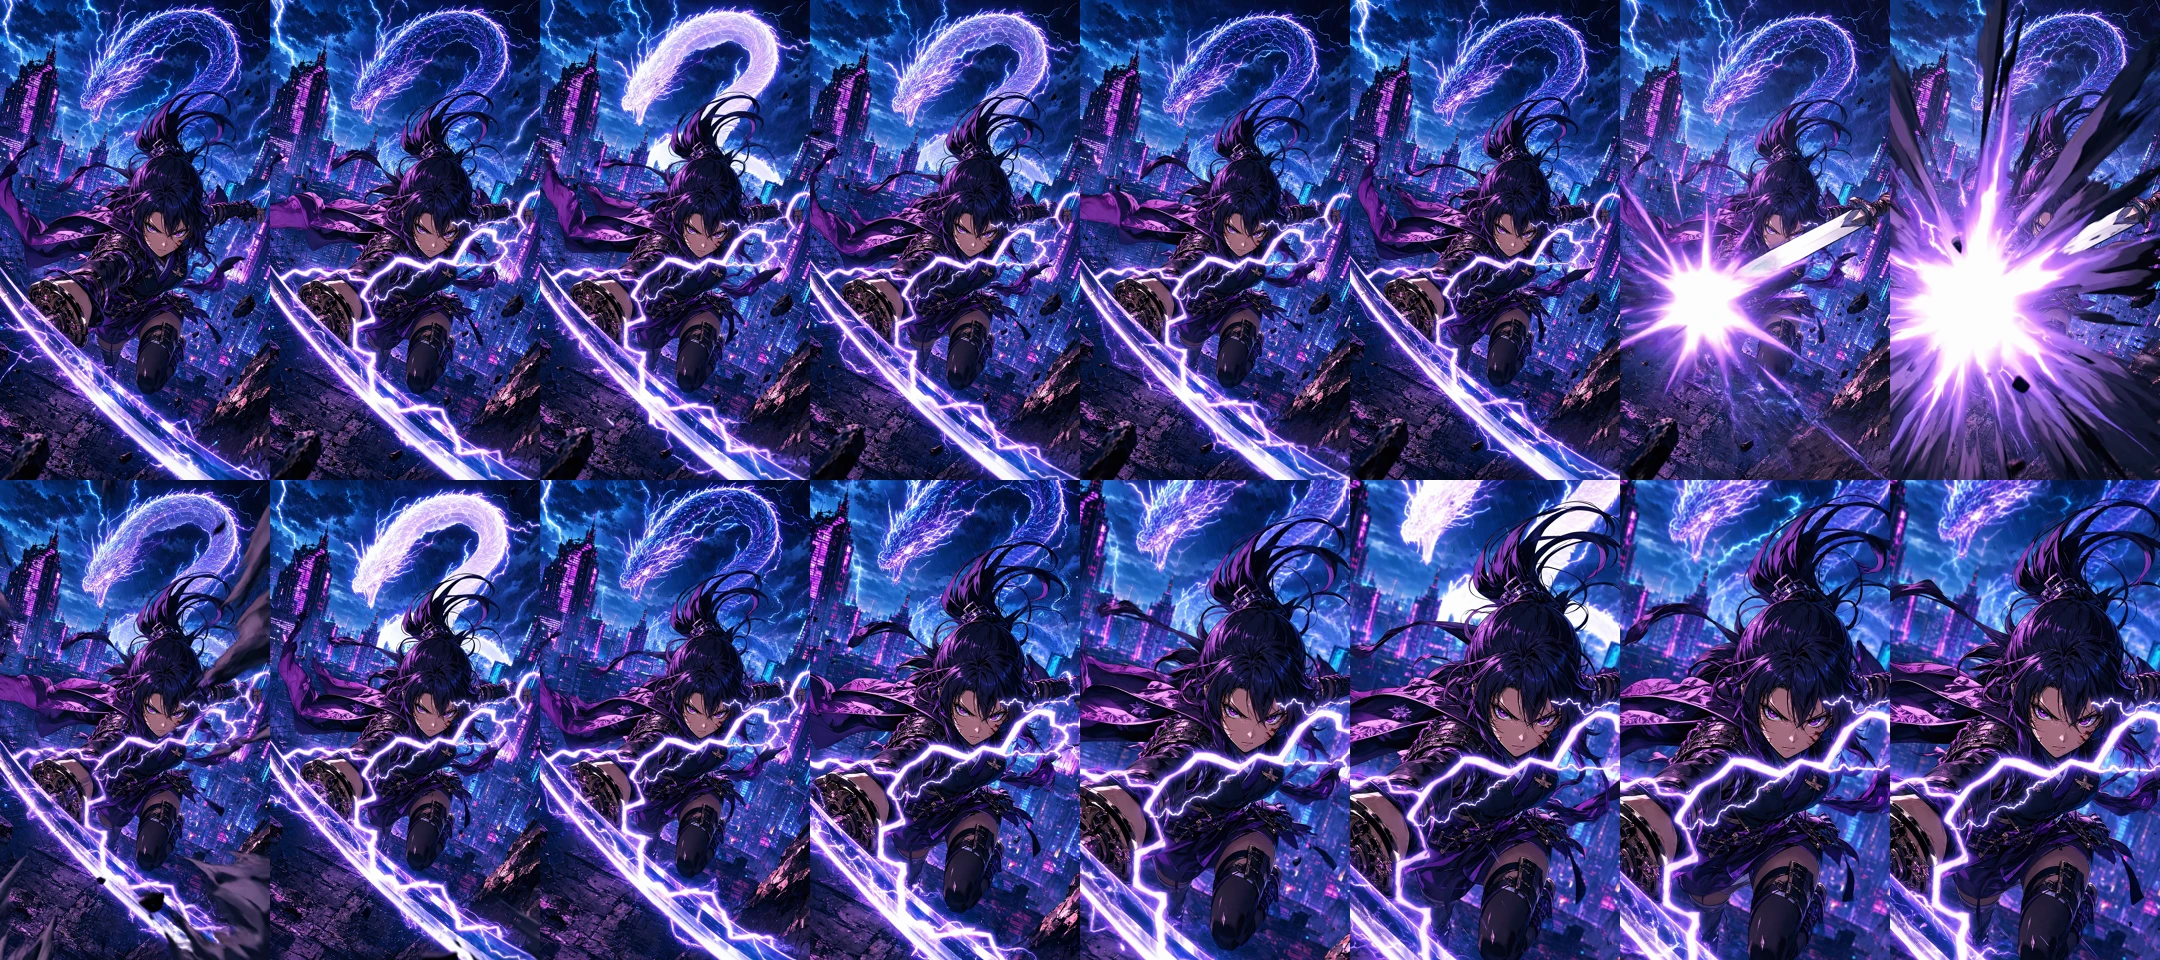
这些帧以每秒两帧的频率抽样,先按顶行从左到右阅读,再读底行。它们是从真实视频中抽取的样本,不是后来生成的静帧替代品。精确的采样时间戳已与本地证据记录一同保存。
这些样本显示,片段中途有一次明亮闪光遮挡了人物的大部分区域,之后出现了更近的女主角视角。她宽大的深色服装和紫蓝色视觉方向在这些样本中仍然可辨认。被遮挡的那段并不能证明手部或剑在整个过程中始终正确。
在制作审核中,请播放整段片段并检查闪光前后的帧。判断动作是否如预期被表达,以及最终裁切是否为下一次剪辑留下了足够空间。我们没有仅凭这张联系表就给出完整运动解剖或流畅度评分。
奇幻示例:环境揭示是另一种测试
记录模型:Vertex AI Veo 3.1 Quality。它与动作示例具有相同的证据限制。
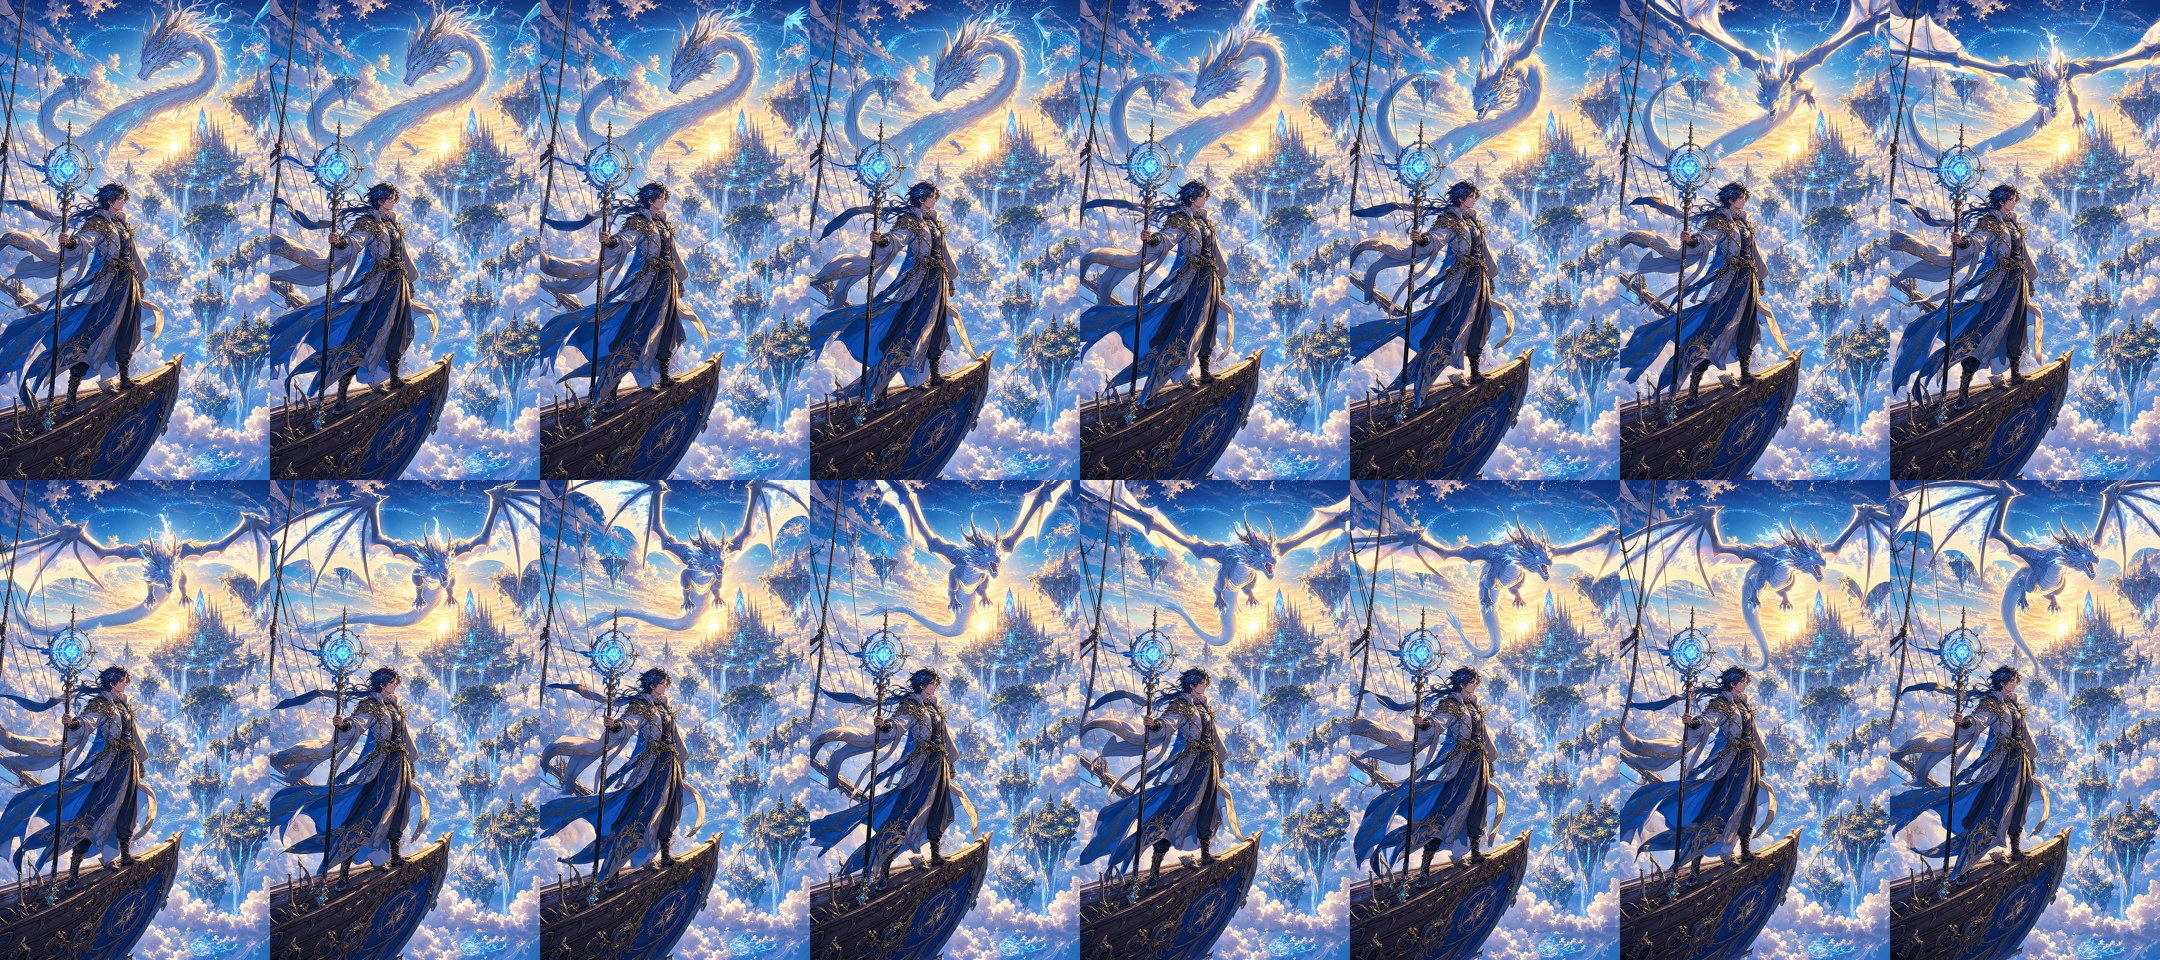
法师在抽样构图中始终接近左下区域,而龙在漂浮城市上方改变了位置和姿态。法杖、飞船场景以及蓝金色视觉方向在样本中依然可辨。这支持的是关于构图的有限观察,而不是所有帧中角色或龙的解剖结构都完美无误的结论。
这些示例属于不同场景,而不是对同一输入施加两种受控动作设置。因此,它们不能证明更慢的提示词更可靠,也不能证明某个提供方优于另一个。它们说明了为什么审核必须与任务匹配:环境揭示与手持道具动作暴露的问题不同。
你可以复现的共享关键帧测试
为了公平比较图片转视频,请在打开各工具之前,先确认一个原创角色并准备三个干净的关键帧。如果角色外观仍未确定,请使用 OC 参考图工作流。
| 镜头 | 关键帧 | 动作请求 | 主要审核问题 |
|---|---|---|---|
| A | 清晰的头肩视图 | 缓慢转向镜头 | 转头过程中脸是否依然可识别? |
| B | 可见的手持单一道具 | 举起道具,然后保持 | 手、物体和握持姿势是否始终清晰可读? |
| C | 未裁切的站立角色 | 简单跟拍下走几步 | 服装、脚部和屏幕方向是否保持可用? |
使用正向、直接的动作指令。以道具镜头为例:
The adult courier slowly raises the brass compass to chest height,
then holds it steady. The character keeps the appearance and clothing
shown in the input image. The camera remains in a steady medium shot.
Movement is restrained, with a clear pause at the end.
请将这视为一个提议中的测试,而不是已完成的基准测试。三个镜头、两次尝试、四个参与者将产生 24 个片段。将某个参与者纳入测试前,请确认其支持所请求的模式。如果 LlamaGen.AI 的分镜工作流无法接受相同的孤立图像任务,则可能需要单独评估。
在可能的情况下使用相同的时长和分辨率。如果控制项不同,请保留原生设置,并相应缩小结论范围。把直接提示词轮次与根据各模型文档提示风格调整后的轮次分开。
请分别记录平台和底层模型。同一个模型通过两个产品提供,并不代表两个独立的模型质量结果,即使工作流不同也是如此。
检查片段内的一致性与镜头切换间的连续性
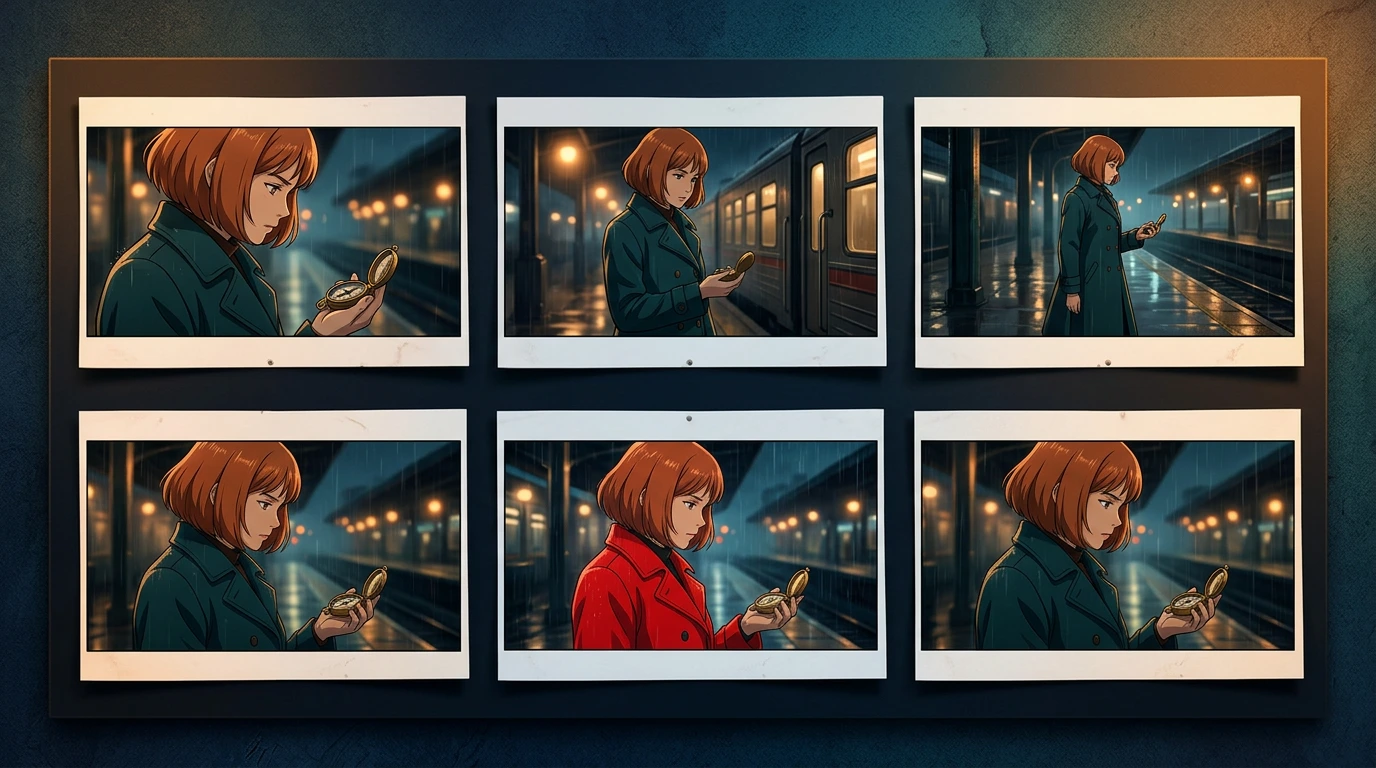
教学示意图:改变后的外套是人为构造的连续性错误,并不是在被比较服务中的某一个实际观察到的失败。
在每个片段内部,检查开头、结尾、动作峰值、遮挡和过渡。寻找面部变化、道具消失、多余手指、服装细节漂移,以及令人分心的线稿变化。抽样帧有助于定位问题;判断节奏和流畅度仍需要完整播放。
在不同片段之间,要检查剪辑点本身。一个镜头中朝右的角色,不应在下一个镜头里意外反转方向。检查哪只手拿着道具、道具比例、服装颜色,以及计划中的动作是否延续。
请使用明确的结果标签:接受、需要修复、拒绝,或未评估。将身份一致性、动作、风格、镜头遵循度和剪辑可用性分开记录。精致的背景不应弥补必需动作不可读的问题。
计算每秒可用素材成本
生成价格和制作成本回答的是不同问题。如果一次尝试生成了 5 秒,但只有最后 2 秒适合剪进成片,那它并不等于 5 秒可用素材。
Cost per usable second = attributable generation and repair cost
                         divided by accepted seconds used in the edit
请计入被拒绝的尝试、付费重生成和必要的超分放大。审核和剪辑时间应单独记录。不要把重复循环片段算作新生成的可用素材。如果没有任何内容通过,请报告“无接受输出”,而不是给出误导性的成本比率。
上文提到的 Runway Gen-4.5 文档费率可作为规划示例:按每秒 12 credits 计算,生成 5 秒即为每次尝试 60 credits。两次这样的尝试就是 120 credits。这只是基于公开费率的算术推导,不是实际观察到的收费,也不是对可用输出的预测。
对于 Vidu、Kling、DomoAI 和当前的 LlamaGen.AI 工作室,请使用界面中针对精确模型、模式和设置显示的价格。我们在这里没有测量这些任务收费。不同平台的 credits 不是可互换的货币单位。我们保留的两个展示片段没有最终成本记录,因此不能支持“最便宜工具”的结论。
在称其为可交付视频之前,先完成整个序列
先确认角色和关键帧,生成小范围动作测试,然后组装已接受的素材。按预期观看尺寸审核剪辑。对白、音乐、字幕和音效应作为独立任务添加或核验,除非具体的生成与导出确实已经包含它们。
使用 Storyboard-to-Video Handoff Checklist 记录镜头顺序、时长、声音说明和修订内容。一个成功的 8 秒片段,并不能证明可以完成整集,或具备可靠的长篇生产速率。
常见问题
2026 年哪款 AI 工具最适合制作动漫视频?
本评测并未得出总体优胜者。请先按输入类型建立候选名单:分镜、静态图、多个参考图,或现有动态素材。然后测试你的剪辑实际需要的动作和连续性。
参考图表能让动漫角色保持完全一致吗?
参考图会为你提供一个设计标准,并可引导受支持的生成模式。但它不能保证每一帧中的身份完全一致。请在运动过程中检查面部、服装、手部和道具。
这五款工具是否使用了相同提示词进行测试?
没有。本对比使用了官方文档,以及对两个保留的 LlamaGen.AI 展示资产进行的有限检查。共享的 24 片段方法是一个提议中的测试,而不是已完成结果。
静态图像对比能证明视频质量吗?
它可以揭示抽样帧中的可见设计变化。但它无法证明运动是否流畅、时序是否准确,或音频是否同步。请观看完整片段,并检查问题时段。
我能通过一次生成做出完整的动漫剧集吗?
不要仅凭短示例做出这种假设。请分别规划镜头、角色连续性、剪辑、声音和交付,并核查当前模型的实际限制。
如果你的源素材本身就是漫画,请继续使用 LlamaGen.AI Comic to Video。先从一个清晰的故事节点开始,并在扩展序列之前先确认实际生成片段。
Related hot tags
AI 动漫
AI 视频
对比
角色一致性
热门创作工具
将灵感变成下一个故事
使用 LlamaGen 创作漫画、分镜和风格化照片。
点燃年轻人的梦想
让千万故事鲜活起来
了解 LlamaGen 最新功能发布、产品增强、设计更新和重要错误修复。