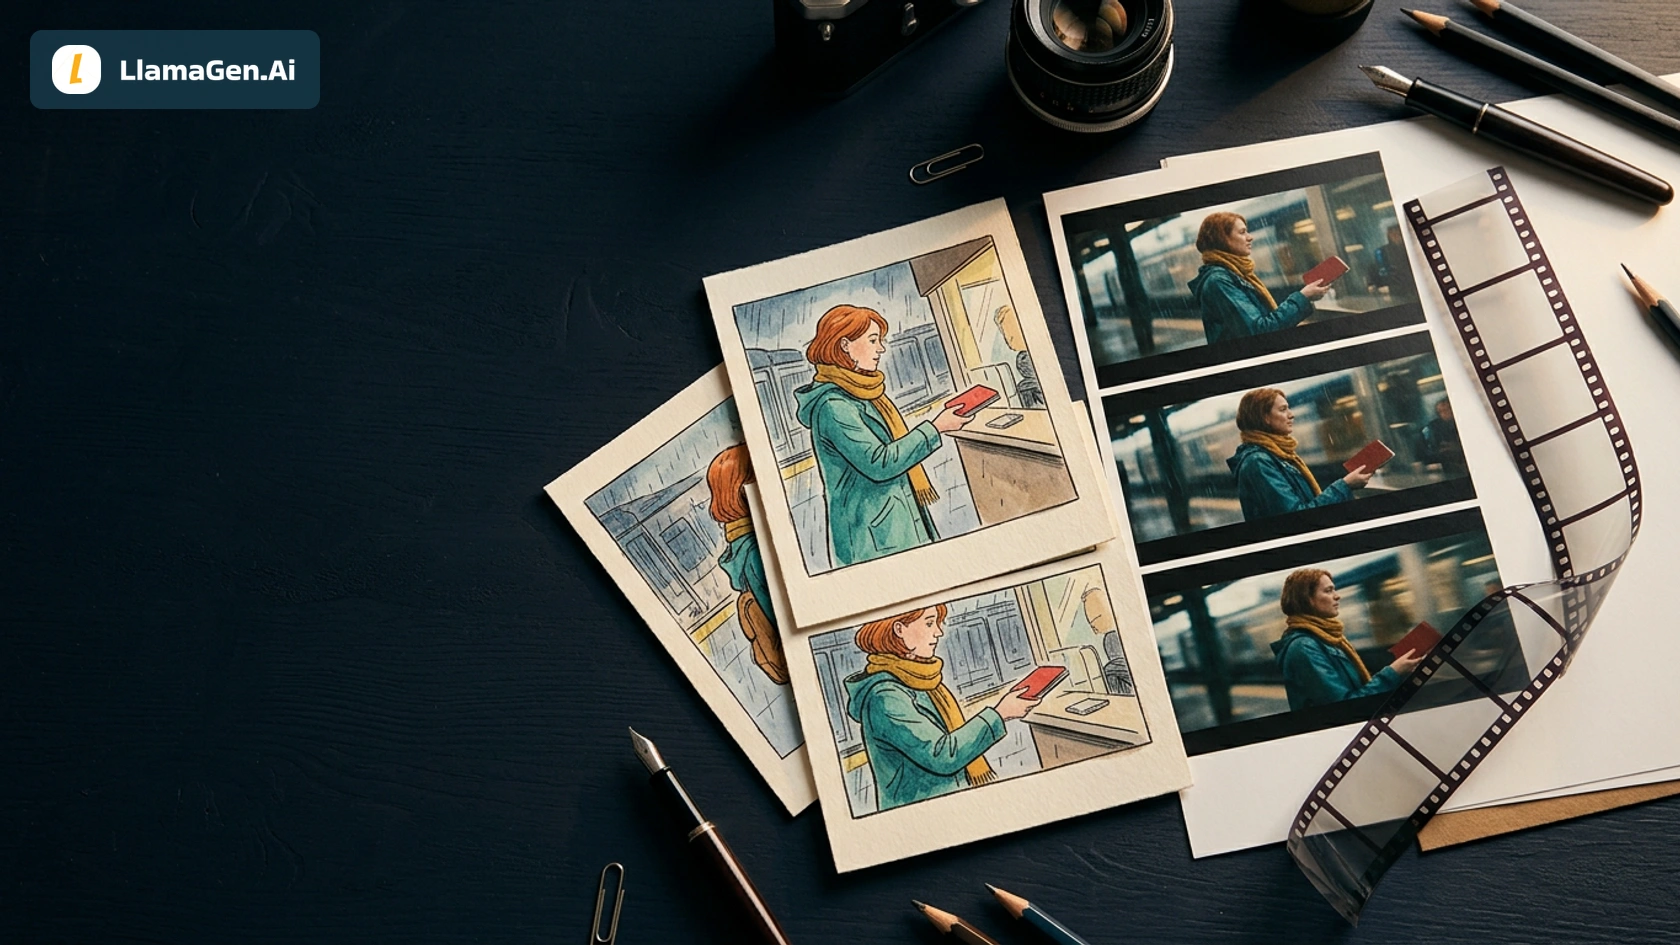

要將漫畫分鏡製作成影片,最好的方式是把場景拆成幾個容易閱讀的動作,而不是要求單張圖片完成整個連續情節。先選好分鏡,為每個鏡頭描述單一動作,生成短片段,接著再剪輯成固定長度。請把原始頁面顯示在時間軸旁邊,方便隨時檢查哪些內容發生了變化。
這個實作範例使用 Maya 原本的紅色筆記本漫畫,並輸出為一支15 秒無聲 MP4。下方包含原始分鏡、三段未剪輯片段、鏡頭說明與最終檔案。如果你想看產品工作流程,請從 LlamaGen.AI Comic to Video 開始。
觀看完成的 15 秒場景
開啟或下載最終 MP4。交付檔案為 720 × 720 像素、24 fps、360 幀,長度 15.00 秒。它沒有音軌。剪輯使用三個五秒鏡頭,並在第 5 秒與第 10 秒進行硬切。內容不包含旁白、音樂或生成對話。
執行日期為 2026 年 11 月 16 日。原始漫畫插圖是使用 LlamaGen.AI 的圖片遊樂場製作。此案例中,分鏡裁切圖透過 Replicate 上的 Google Veo 3.1 Fast 進行動畫生成,回傳片段再以 FFmpeg 組裝。這是一條有記錄的手動製作流程,而不是已登入的 LlamaGen.AI Comic-to-Video 或 Studio 工作階段錄製。公開產品頁面則另行檢視。
1. 從既有漫畫中選出三個關鍵節點
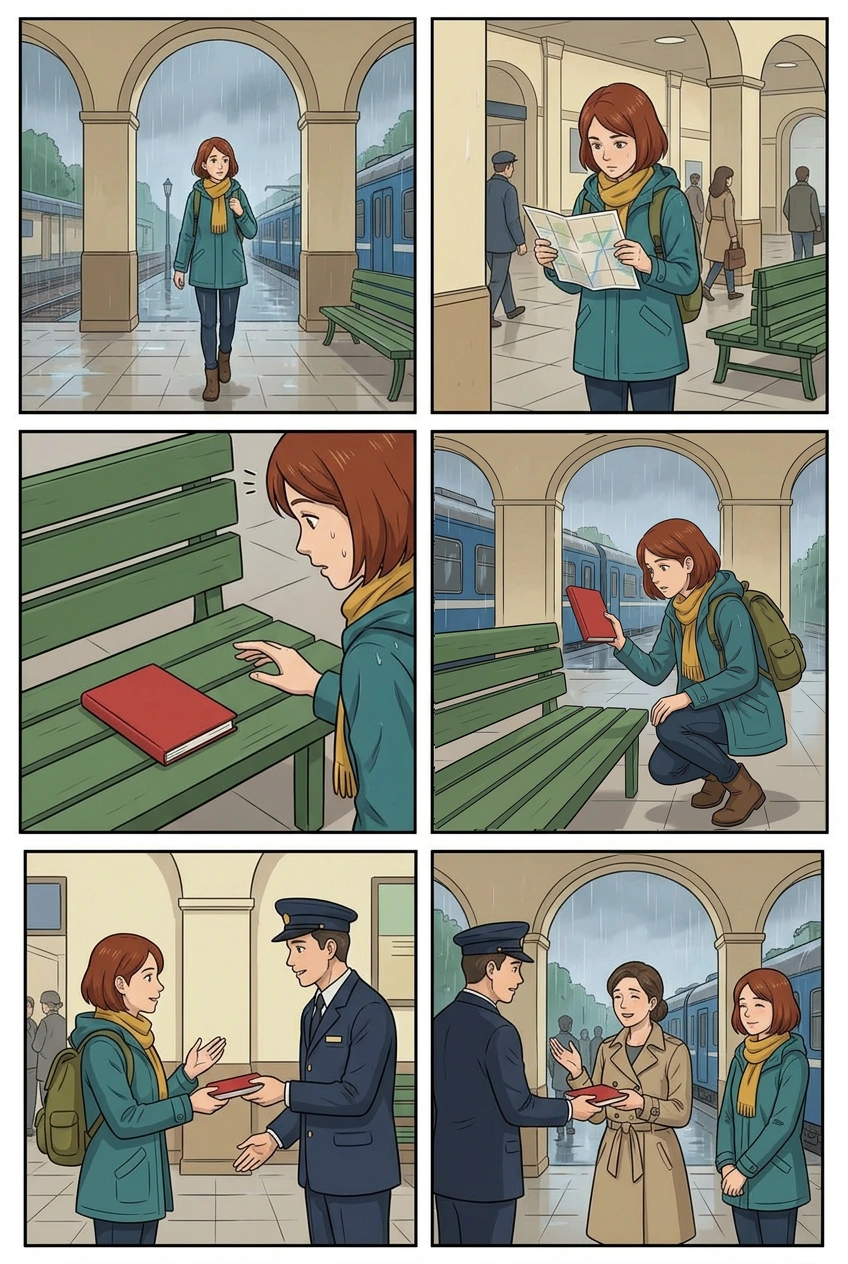
這是來自六格參考圖片教學的自有教學頁面。這裡重用了原始素材,而不是新生成的影片成果。Maya 留著短短的紅棕色鮑伯頭,穿著藍綠色雨衣、芥末黃圍巾,以及橄欖綠背包。一本文字闔上的紅色筆記本串起整段動作。
完整漫畫包含抵達、查看地圖、發現筆記本、拿起它、詢問服務人員,以及將它歸還給失主。這支短片只選用了第 3、5、6 格:
| 剪輯時間 | 來源分鏡 | 單一要求動作 | 此剪接省略的內容 |
|---|---|---|---|
| 0–5 秒 | 3:長椅上的筆記本 | Maya 的手靠近並碰到封面 | 第 4 格中後續拿起的動作 |
| 5–10 秒 | 5:Maya 與服務人員 | 朝服務人員進行一個小小的交接動作 | 從長椅走到櫃台的過程 |
| 10–15 秒 | 6:歸還給失主 | 失主接過筆記本;Maya 露出笑容 | 失主先前抵達的部分 |
這些省略的步驟屬於剪輯壓縮。這是一段簡短場景摘要,並不表示六格全部都被動畫化,也不表示影片呈現了每一個中間動作。如果撿起的動作對你的場景至關重要,請加入第 4 格並重新調整鏡頭預算。
如果你想了解定時分鏡與生成角色動作之間該如何選擇,請參考 Motion Comic vs. Animatic。此範例包含生成的手部與臉部動作,之後再進行本地剪輯。
2. 為每個鏡頭準備一張圖片
每個選中的分鏡都從既有頁面中裁切而來。裁切保留了角色與道具;影片輸入並沒有生成新的角色設計。每張裁切圖都被放置到 720 × 1280 的象牙白畫布上,且沒有拉伸原始插圖。這樣可產出受支援的 9:16 起始圖片,同時保留原本大致為正方形的漫畫構圖。
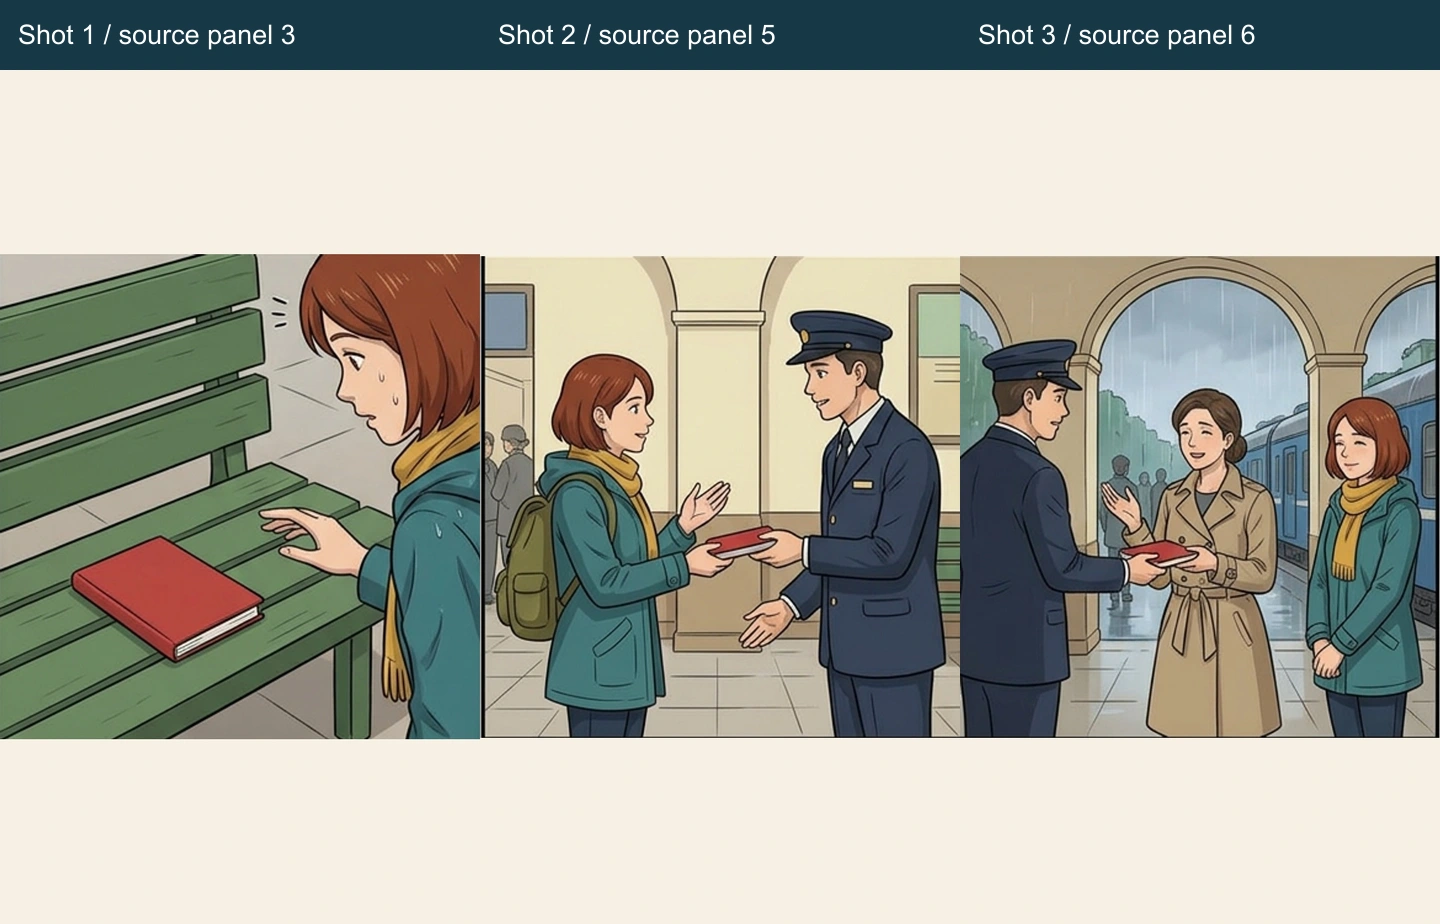
這些就是實際使用的輸入圖片,標籤是在本地另外加上的。象牙白區域是前置處理的留白,不是模擬的影片介面。回傳影片也保留了相當多的邊界空白。最終剪輯以中央正方形裁切去除這些邊界,因此得到上方顯示的 720 × 720 交付版本。
不同的交付格式可能需要不同的構圖。不要把交接鏡頭裁得太緊,以致筆記本或接收的手消失不見。在送出生成請求前,先檢查目標畫面的取景。
3. 撰寫有邊界的動作指示
動作請求應明確說明哪些內容可以動、哪些內容必須保持穩定。以鏡頭 1 為例,筆記本已經出現在畫面中。如果要求 Maya 去發現它、撿起它、打開它、閱讀它,再跑開,就會在一段短片中引入過多新的狀態。
實際用於鏡頭 1 的指示,是要求一個小幅度的伸手與接觸動作:
Maya notices the red closed notebook on the green bench.
Her near hand approaches and rests lightly on its cover.
Keep the notebook on the bench, rigid, closed and red throughout.
Preserve her auburn bob, teal coat and mustard scarf.
Fixed camera, no cuts, no new people, no text or speech.
鏡頭 2 指定 Maya 在左側、穿制服的服務人員在右側,並有一本筆記本朝服務人員移動。鏡頭 3 則維持服務人員在左、失主在中、Maya 在右,呈現一個小幅歸還動作與如釋重負的微笑。三個鏡頭都要求保留插畫風格、穩定的臉部、有限動作,以及不生成音訊。
下載完整鏡頭指示,查看精確提示詞與來源裁切座標。這些是實際使用的指示,不是從最終宣傳片反推而來的提示詞。
目前的模型 API schema 是受支援輸入的參考依據。模型可用性與選項可能變動。以下設定描述的是這次帶有日期記錄的執行,並不保證未來每個產品帳號都會提供相同的模型或控制項。
4. 保留原始生成片段
每次成功請求都使用 google/veo-3.1-fast、9:16 圖像輸入、要求 6 秒長度、720p 解析度,且停用音訊。所有三個下載輸出都透過媒體探測檢查:720 × 1280、24 fps、6.00 秒。
| 片段 | 模型 / 供應商 | 本次執行中的請求至完成時間 | 原始檔案 |
|---|---|---|---|
| 發現 | Veo 3.1 Fast / Replicate | 62.2 秒 | 六秒 MP4 |
| 交接 | Veo 3.1 Fast / Replicate | 40.6 秒 | 六秒 MP4 |
| 歸還 | Veo 3.1 Fast / Replicate | 45.1 秒 | 六秒 MP4 |
這些時間是根據請求與完成時間戳記計算。它們不包含來源選取、授權排錯、下載、審閱與剪輯;因此不應視為端到端完成時間的估算。由於最終計費與 LlamaGen.AI Studio 點數資料不可用,此案例不對每支影片成本作任何主張。
交接請求是在提交中斷後,從供應商的 prediction history 中找回,再從該既有工作下載。它不是為了挑選更好的結果而刻意生成兩次。此處保留了三個成功的片段輸出,沒有丟棄的視覺生成結果,也未宣稱任何失敗率。
5. 檢查動作、角色一致性與筆記本
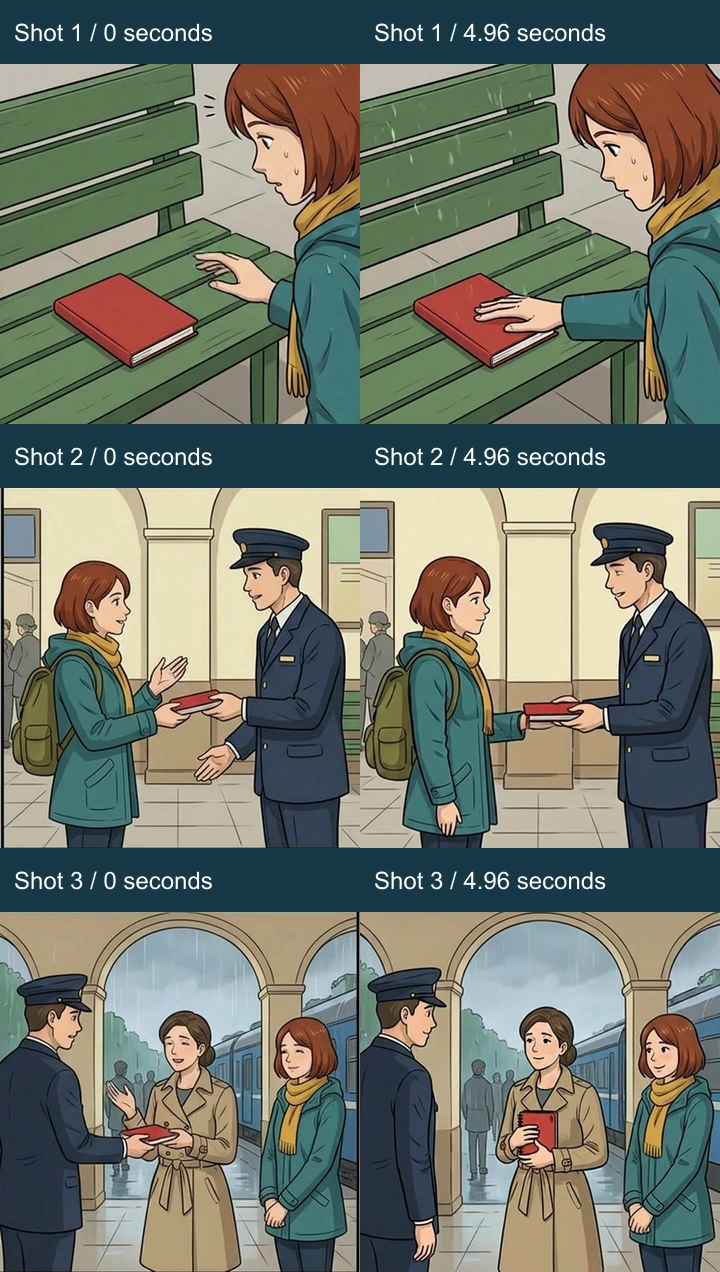
這些是真實畫格,取樣自每個所選片段的開頭與大約 4.96 秒處。它們有助於進行可視比較,但不能取代直接觀看中間的動作變化。
在鏡頭 1 中,Maya 的手伸向紅色筆記本並停在封面上。模型同時在長椅區域加入了明顯的雨絲效果。由於她的臉在來源圖中本來就部分被裁掉,因此這個鏡頭更能證明手部與道具的一致性,而不是完整的臉部身份。
在鏡頭 2 中,服務人員扶著筆記本,而 Maya 放下一隻手。在所選的結尾畫面中,她的另一隻手仍靠近書本,因此這個剪接本身無法獨立證明交接已經完全完成。下一個鏡頭才建立服務人員將它歸還給失主。如果你的故事需要一個乾淨且毫不含糊的所有權轉移,請在把它當作最終母版前,先修改或延長這個鏡頭。
在鏡頭 3 中,失主把紅色書本抱向胸前,而 Maya 露出笑容。Maya 的紅棕色頭髮、藍綠色外套與芥末黃圍巾仍然清楚可辨。較細小的手指、衣物摺痕,以及筆記本的邊緣或裝訂細節會在畫格之間有所變化。這些差異屬於保留下來的輸出結果之一部分,並不保證道具幾何完全精確一致。
紅色筆記本在這三個選定動作中始終可見。場景不包含可讀對話、嘴型同步語音,或文字保留測試。如果你的漫畫依賴這些元素,請另外進行檢查。
6. 剪輯至精確 15 秒
回傳素材總長為 18 秒。最終剪輯取每段片的前五秒,以中央 720 像素正方形裁切移除象牙白邊界,將畫格統一為 24 fps,並依來源順序接合各段。FFmpeg 執行修剪、裁切、H.264 匯出,以及快速啟動 MP4 封裝。
這屬於剪輯層面的時長與取景修訂。本文並未主張影片模型能在一次請求中直接產出完成的 15 秒序列。此案例中的三段片段沒有進行任何視覺重新生成,也沒有為了比較而人為建立「失敗版本」。
來源頁面、原始片段與最終剪輯,分別回答不同的審查問題:來源頁面建立已核准的故事內容;原始片段揭示動作模型改變了什麼;最終 MP4 則顯示實際節奏與取景。當你把場景交給另一位剪輯師時,請把這三者一併保留。
你可以為自己的漫畫重用什麼
挑選一個穩定的核心道具與少量角色。為每個鏡頭設定起始狀態、一個動作,以及結束狀態。在動作足夠清楚之前,請先保持鏡頭簡單。當文字與聲音很重要時,請分開請求,並檢查匯出檔案的實際時長、畫面尺寸與音軌。
在進入較大型製作前,請使用 Storyboard-to-Video Handoff Checklist 來定義可接受畫格、鏡頭方向與交付需求。若想了解模型選擇背景,請參考 anime video generator comparison,但要注意其本身也有測試限制。
從 LlamaGen.AI Comic to Video 或 comic-strip workflow 開始。這個案例展示了你需要準備與檢查的內容,而可下載檔案則保留了實際用來建立此場景的手動流程。
Related hot tags
漫畫轉影片
動畫
實作範例
教學
熱門創作工具
將靈感變成下一個故事
使用 LlamaGen 創作漫畫、分鏡與風格化照片。

點燃年輕人的夢想
讓數百萬個故事活靈活現
彙整最新的 LlamaGen 功能發布、產品強化、設計更新與重要錯誤修正。