
要将漫画分镜制作成视频,最好把场景拆分为几个易于理解的动作,而不是让一张图片完成整个连续过程。先选出分镜,为每个镜头描述一个动作,生成短片段,然后将它们剪辑成固定时长。将源页面显示在时间轴旁边,这样你就可以检查哪些内容发生了变化。
这个完整示例使用 Maya 原始的红色笔记本漫画,并输出一个15 秒无声 MP4。下方包含源分镜、三个未剪辑片段、镜头说明以及最终文件。如果你想查看产品工作流程,请从 LlamaGen.AI Comic to Video 开始。
观看完成的 15 秒场景
打开或下载最终 MP4。交付文件为720 × 720 像素、24 fps、360 帧、15.00 秒。它没有音轨。剪辑由三个 5 秒镜头组成,并在 5 秒和 10 秒处进行硬切。它不包含旁白、音乐或生成的对白。
执行时间为 2026 年 11 月 16 日。原始漫画插图由 LlamaGen.AI 的图片创作工具制作。在本案例中,分镜裁切图通过 Replicate 上的 Google Veo 3.1 Fast 制作动画,返回的片段使用 FFmpeg 进行组装。这是一条有文档记录的手动制作流程,而不是已登录的 LlamaGen.AI Comic-to-Video 或 Studio 会话录屏。公开产品页面已另行审阅。
1. 从现有漫画中选择三个关键节拍
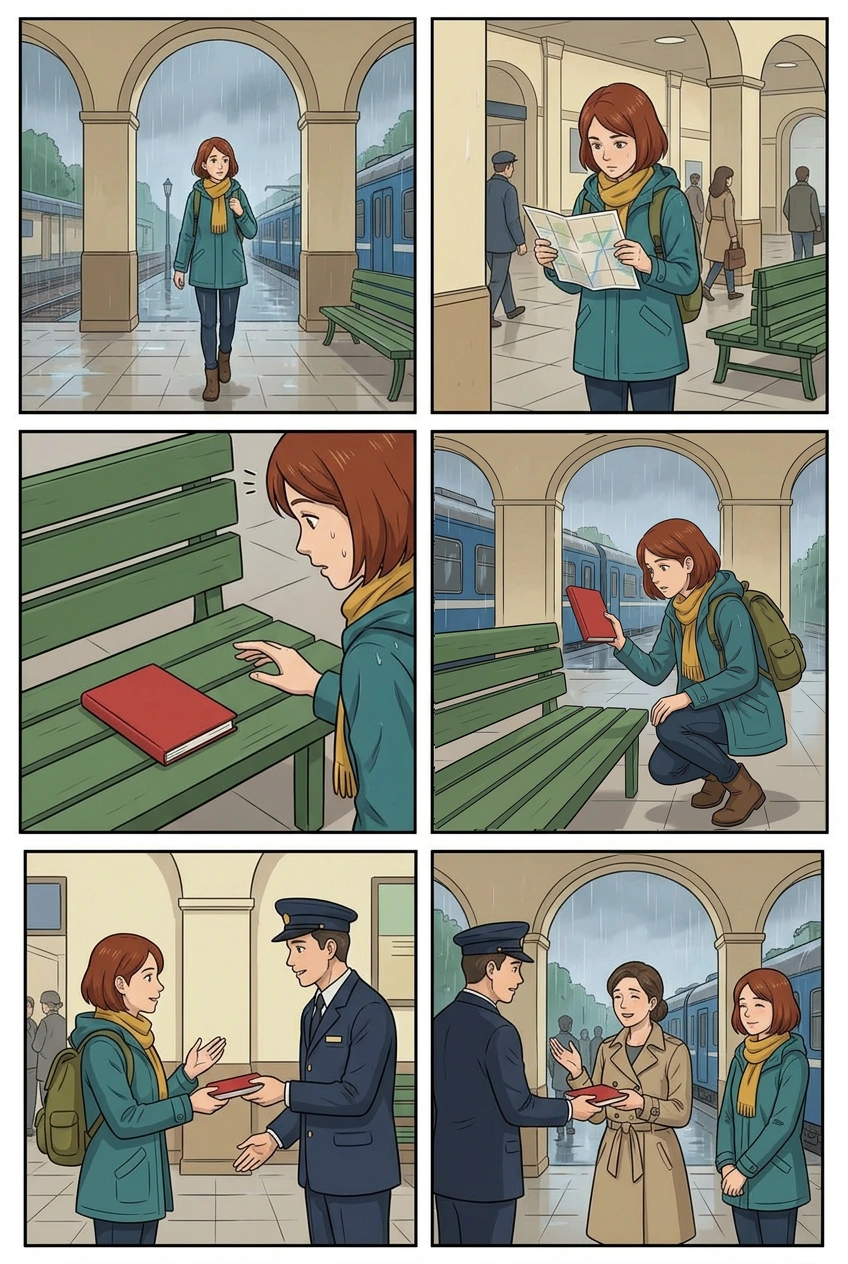
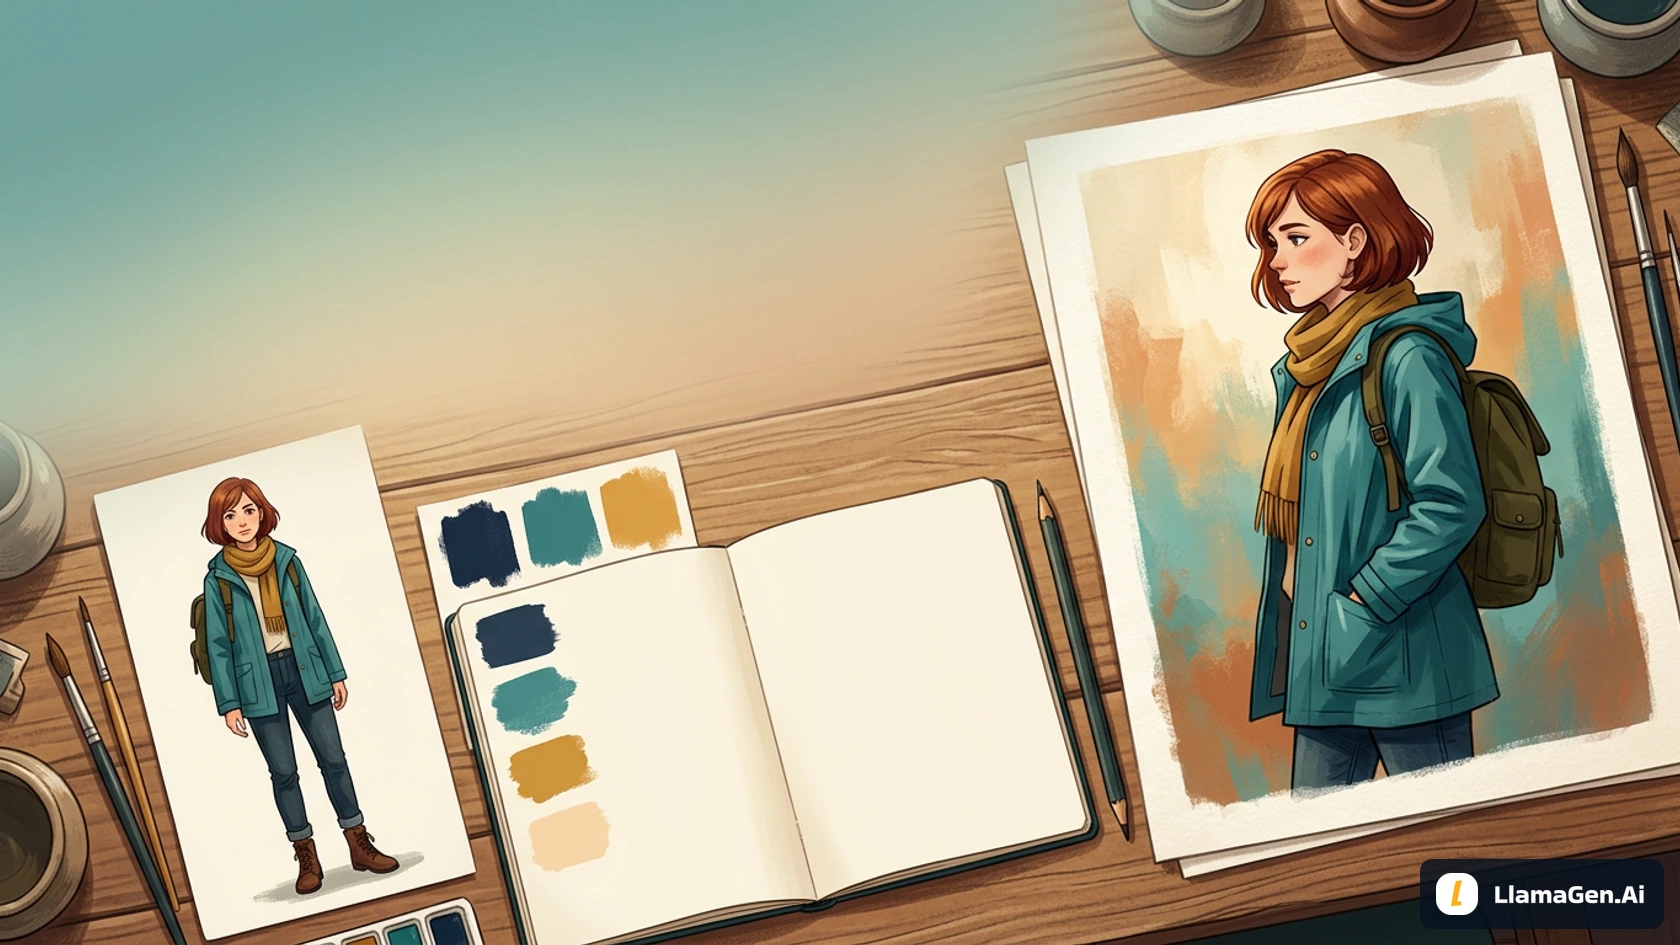
这是来自六格参考图漫画教程的自有教学页面。它是复用的源艺术素材,不是新生成的视频结果。Maya 留着赤褐色短波波头,穿青绿色雨衣、芥末黄色围巾,背橄榄绿色背包。一本合上的红色笔记本串联起整个动作过程。
完整漫画包括到达、查看地图、发现笔记本、拿起它、询问服务员,以及归还给主人。这部短片只选取了第 3、5 和 6 格:
| 剪辑时间 | 源分镜 | 一个请求的动作 | 这一剪切省略了什么 |
|---|---|---|---|
| 0–5 秒 | 3:长椅上的笔记本 | Maya 的手靠近并触碰封面 | 第 4 格中的后续拿起动作 |
| 5–10 秒 | 5:Maya 与服务员 | 朝服务员做一个小幅交接动作 | 从长椅走到服务台的过程 |
| 10–15 秒 | 6:归还给主人 | 主人接过笔记本;Maya 微笑 | 主人更早之前的到达过程 |
这些省略的步骤属于剪辑压缩。这是对短场景的概括,而不是声称六格都做成了动画,或影片展示了所有中间动作。如果“拿起”对你的场景至关重要,请加入第 4 格并调整镜头预算。
如需了解定时分镜板与生成角色动作之间的选择,请参见 Motion Comic vs. Animatic。本示例包含生成的手部和面部动作,之后再进行本地剪辑。
2. 为每个镜头准备一张图片
每个选中的分镜都从现有页面中裁切出来。裁切保留了角色和道具;视频输入中没有生成新的角色设计。每张裁切图都被放置到 720 × 1280 的米白色画布上,且不拉伸原始插图。这样就得到了一张受支持的 9:16 起始图片,同时保留了大致方形的漫画构图可见。
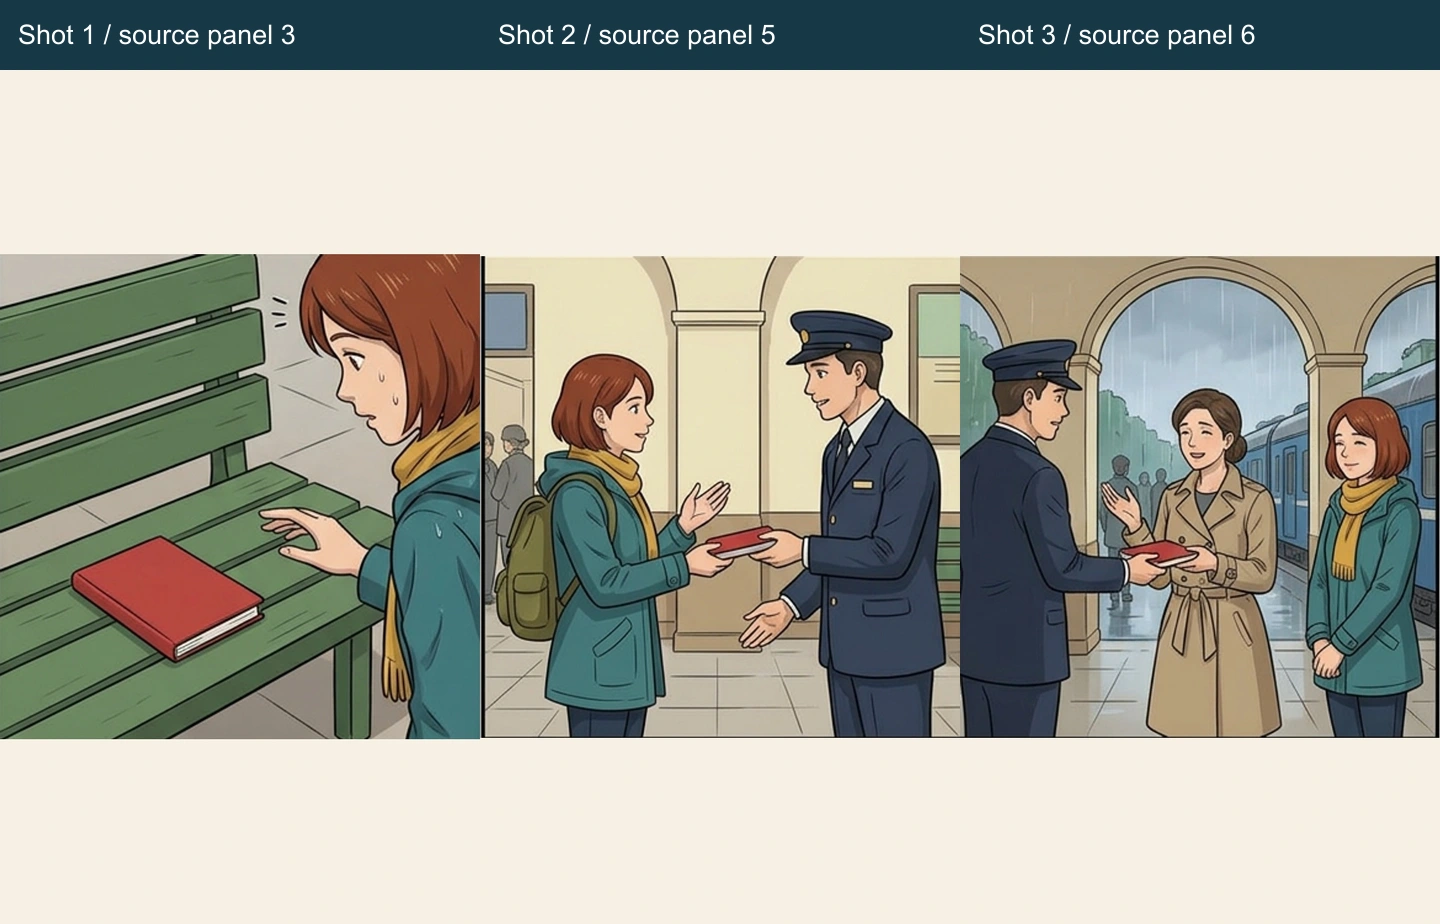
这些是实际输入图片,标签为本地添加。米白色区域是准备时的留白边距,并不是模拟的视频界面。返回的视频同样保留了大量留边。最终剪辑通过中心正方形裁切去除了这些边距,生成上方所示的 720 × 720 成品。
不同的交付格式可能需要不同的构图。不要把交接动作裁得过紧,以至于笔记本或接收的手消失。在花费一次生成请求之前,先检查目标画面构图。
3. 编写有边界的动作说明
动作请求应明确哪些内容可以移动,哪些内容应保持稳定。对于镜头 1,笔记本已经可见。如果要求 Maya 去发现它、拿起它、打开它、阅读它,再跑开,就会在一个短片段中引入多个新状态。
实际用于镜头 1 的说明请求了一个小幅伸手并接触的动作:
Maya notices the red closed notebook on the green bench.
Her near hand approaches and rests lightly on its cover.
Keep the notebook on the bench, rigid, closed and red throughout.
Preserve her auburn bob, teal coat and mustard scarf.
Fixed camera, no cuts, no new people, no text or speech.
镜头 2 指定 Maya 在左侧、穿制服的服务员在右侧,并且只有一本笔记本朝服务员移动。镜头 3 保持服务员在左、主人在中间、Maya 在右,并表现一个小幅归还动作和一个如释重负的微笑。三个镜头都要求插画风格、面部稳定、动作有限,以及不生成音频。
下载完整镜头说明 以查看精确提示词和源裁切坐标。这些是实际使用的说明,而不是从完成后的宣传片中反向推导出的提示词。
当前模型 API schema 是受支持输入的参考。模型可用性和选项可能会变化。以下设置描述的是这次带日期的运行记录;并不保证未来每个产品账号都提供相同的模型或控制项。
4. 保留原始生成片段
每次成功请求都使用了 google/veo-3.1-fast、9:16 图片输入、请求时长 6 秒、720p 分辨率,并关闭音频。三个下载后的输出都经过媒体探测检查:720 × 1280、24 fps、6.00 秒。
| 片段 | 模型 / 提供方 | 本次运行中的请求到完成时间 | 原始文件 |
|---|---|---|---|
| 发现 | Veo 3.1 Fast / Replicate | 62.2 秒 | 6 秒 MP4 |
| 交接 | Veo 3.1 Fast / Replicate | 40.6 秒 | 6 秒 MP4 |
| 归还 | Veo 3.1 Fast / Replicate | 45.1 秒 | 6 秒 MP4 |
这些时间基于请求和完成时间戳。它们不包括源素材选择、授权排障、下载、审阅和剪辑;并不是端到端完成时间的估算。由于无法获得最终结算账单和 LlamaGen.AI Studio 点数,本案例不对单个视频成本作出任何声明。
交接请求是在一次提交中断后,从提供方的 prediction history 中恢复出来的,然后从那个现有任务中下载。它并不是为了选择更好的结果而故意生成两次。保留了三个成功的片段输出,没有被丢弃的视觉生成结果,也没有声称任何失败率。
5. 检查动作、角色一致性和笔记本
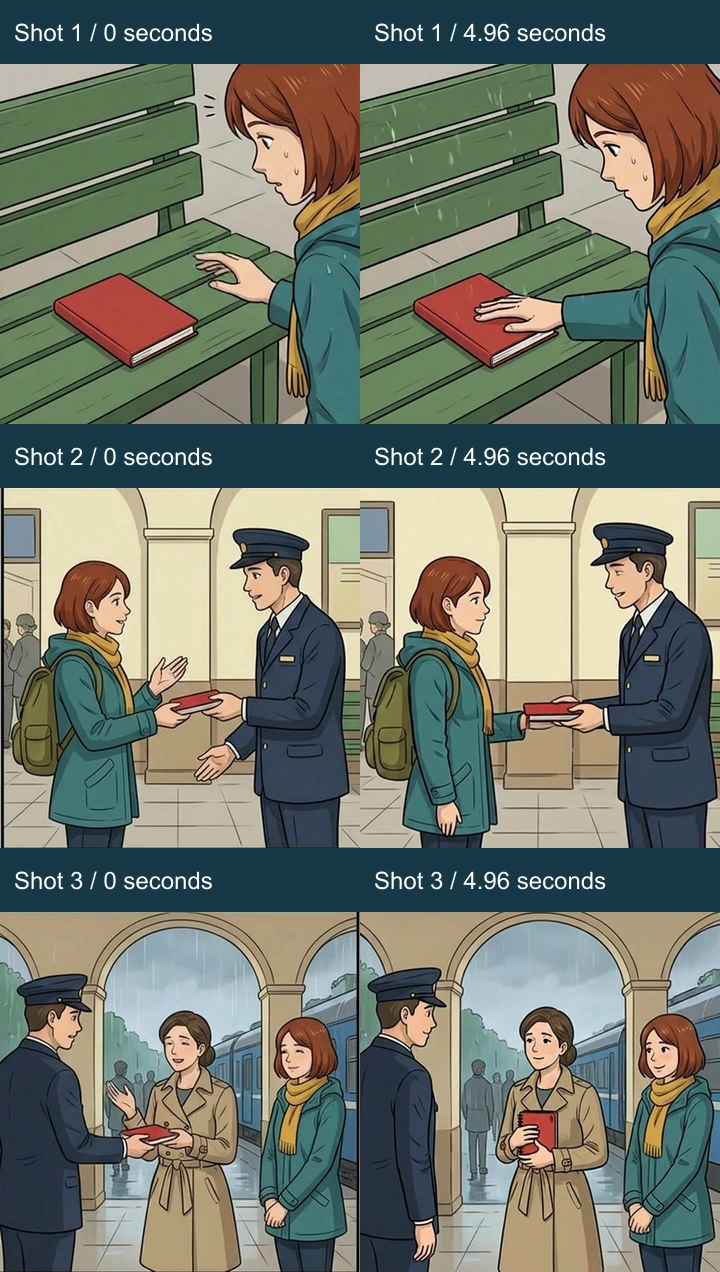
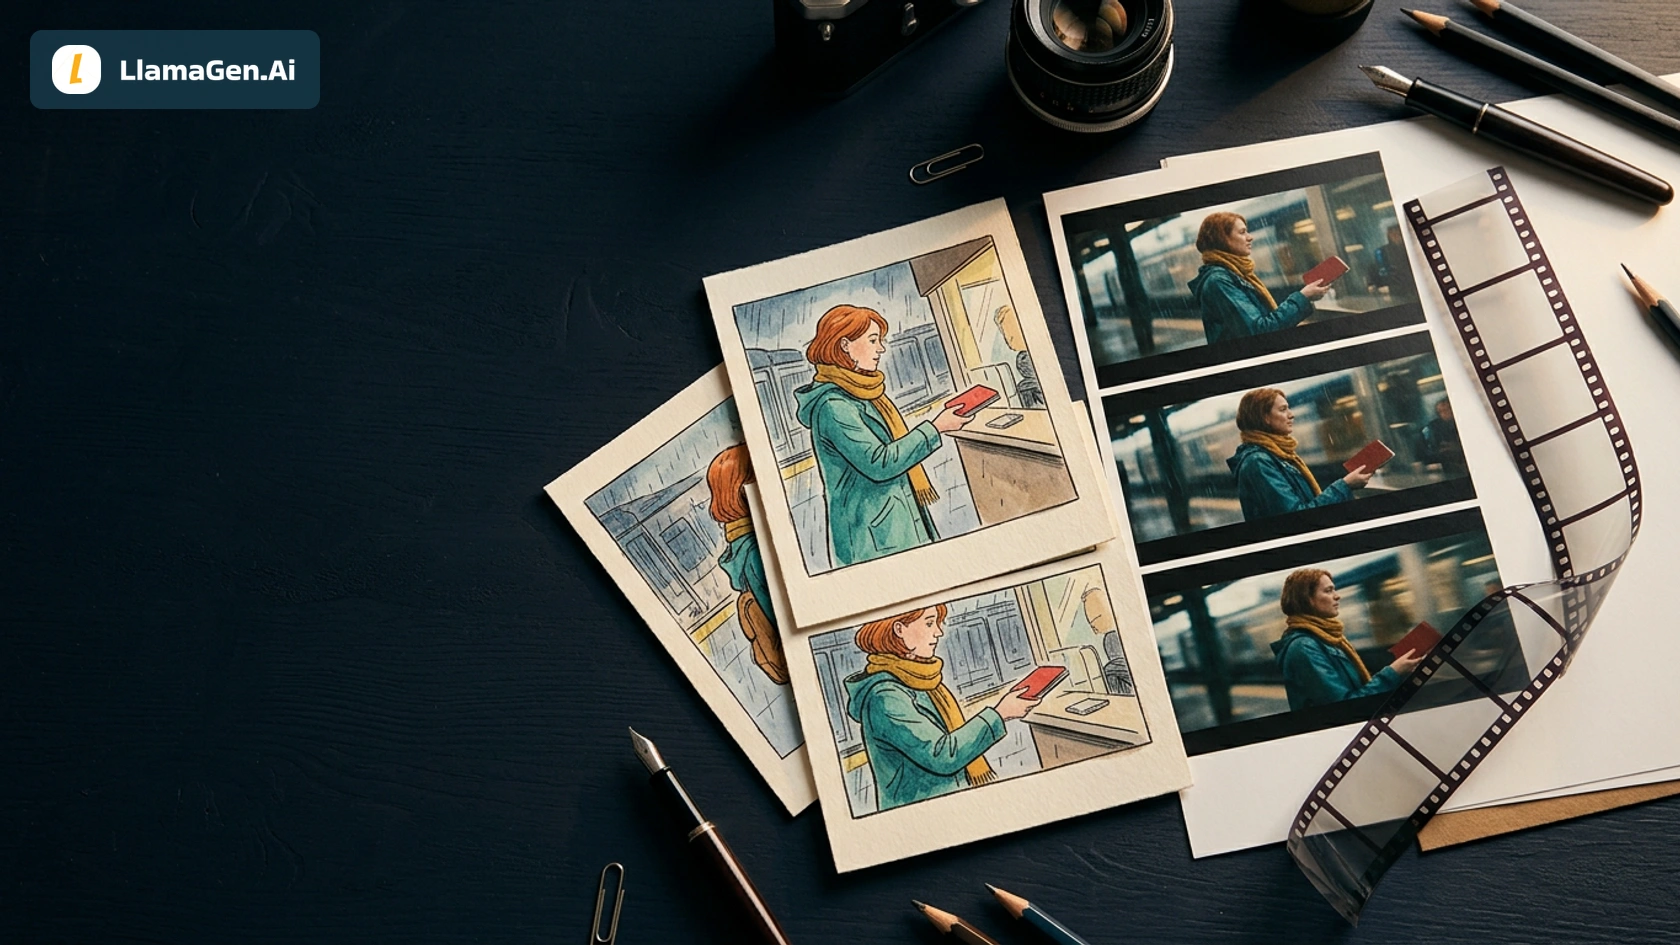
这些是真实帧,采样于每个选定片段的开头以及大约 4.96 秒处。它们有助于进行可视化对比,但不能替代观看两者之间的动态过程。
在镜头 1 中,Maya 的手伸向红色笔记本并停在封面上。模型还在长椅区域加入了可见的雨丝。由于她的脸在源图中本来就有一部分被裁掉,因此这个镜头对手部和道具的证明力强于对完整面部身份的证明力。
在镜头 2 中,服务员托住笔记本,而 Maya 放下一只手。在所选的结束点,她的另一只手仍靠近书本,因此这个剪切本身并不能独立证明一次完全完成的松手。下一个镜头建立了服务员将其归还给主人的动作。如果你的故事需要一个干净、明确的所有权转移,请在将此镜头作为最终母版前修订或延长它。
在镜头 3 中,主人将红色书本抱向胸前,而 Maya 面带微笑。Maya 的赤褐色头发、青绿色外套和芥末黄色围巾仍然清晰可辨。更细小的手指、衣物褶皱,以及笔记本边缘或装订细节会在帧之间发生变化。这些差异属于保留输出的一部分,并不保证道具几何形态完全精确。
在选定的三个动作中,红色笔记本始终保持可见。场景中不包含可读对白、口型同步语音,或文字保真度测试。如果你的漫画依赖这些内容,请单独检查这些要求。
6. 剪辑到精确的 15 秒
返回素材总时长为 18 秒。最终剪辑取每个片段的前 5 秒,使用中心 720 像素正方形裁切去除米白色留边,将帧率统一为 24 fps,并按源顺序拼接各片段。FFmpeg 负责完成裁切、裁剪、H.264 导出以及快速启动 MP4 封装。
这是一次关于时长和画面构图的剪辑修订。并未声称视频模型通过一次请求就生成了一个完成的 15 秒序列。在本案例中,这三个片段没有进行任何视觉重生成,也没有人为制造“失败版本”用于比较。
源页面、原始片段和最终剪辑回答的是不同的审查问题:页面确立获批的故事;片段揭示动作模型改动了什么;最终 MP4 展示实际节奏和构图。将场景交给另一位剪辑师时,请把这三者全部保留。
你可以为自己的漫画复用什么
选择一个稳定的道具和一个小规模角色阵容。为每个镜头设定起始状态、一个动作和结束状态。在动作能够被清楚读懂之前,保持镜头语言简单。当文字和声音很重要时,请分别发起请求,并检查导出文件的实际时长、画面尺寸和音轨。
在更大规模的制作之前,使用 Storyboard-to-Video Handoff Checklist 来定义可接受帧、镜头方向和交付要求。关于模型选择的背景信息,请参阅 anime video generator comparison,其中也有其自身的测试限制。
从 LlamaGen.AI Comic to Video 或 comic-strip workflow 开始。本案例展示了需要准备和检查的内容,而可下载文件则保留了创建该场景时实际使用的手动流程。
Related hot tags
漫画转视频
动画
完整示例
教程
热门创作工具
将灵感变成下一个故事
使用 LlamaGen 创作漫画、分镜和风格化照片。

点燃年轻人的梦想
让千万故事鲜活起来
了解 LlamaGen 最新功能发布、产品增强、设计更新和重要错误修复。